آنچه در این مقاله میخوانید
دیتابیس چیست؟ راهنمای کامل انواع دیتابیس ها
 هنگامه رحیمی
۱۹ شهریور ۱۴۰۵
خلاصه کنید:


هر بار که در یک فروشگاه آنلاین جستجو میکنید، محصولی به سبد خرید اضافه میکنید یا وارد یک اپلیکیشن میشوید، حجم زیادی از اطلاعات در پشت صحنه پردازش و مدیریت میشود. این اطلاعات میتوانند شامل مشخصات کاربران، سوابق تراکنشها، موجودی محصولات یا تنظیمات یک سرویس باشند.
با افزایش حجم دادهها، ذخیرهسازی ساده اطلاعات دیگر پاسخگوی نیاز سیستمهای مدرن نیست. اپلیکیشنها و سرویسهای دیجیتال به روشی نیاز دارند که بتوانند دادهها را سازماندهی کنند، سریع به آنها دسترسی داشته باشند و امنیت آنها را حفظ کنند. اینجا است که دیتابیس به یکی از اجزای اصلی زیرساخت نرمافزار تبدیل میشود.
دیتابیس چیست و چرا اهمیت دارد؟
دیتابیس یک سیستم برای ذخیرهسازی، سازماندهی، مدیریت و محافظت از دادهها است. این سیستم از دو بخش اصلی تشکیل میشود: زیرساختی که دادهها روی آن ذخیره میشوند و نرمافزاری که وظیفه مدیریت، پردازش و کنترل دسترسی به دادهها را بر عهده دارد.
دیتابیسها به سازمانها کمک میکنند حجم زیادی از اطلاعات را به شکل ساختاریافته مدیریت کنند و در زمان نیاز، دسترسی سریع و قابل اعتماد به دادهها داشته باشند. بسیاری از سرویسهای دیجیتال مانند وبسایتها، اپلیکیشنها و پلتفرمهای آنلاین برای عملکرد صحیح به دیتابیس وابسته هستند.
برای مثال، اطلاعات محصولات یک فروشگاه اینترنتی، حسابهای کاربری، سوابق سفارشها و نتایج جستجو همگی میتوانند در دیتابیس ذخیره و مدیریت شوند. انتخاب نوع مناسب دیتابیس نیز به نوع داده و نیاز سیستم بستگی دارد؛ برای نمونه، دیتابیسهای رابطهای برای دادههای ساختاریافته و دیتابیسهای غیررابطهای برای دادههایی با ساختار انعطافپذیر استفاده میشوند.
تفاوت دیتابیس با فایل های معمولی چیست؟
دیتابیس و فایلهای معمولی هر دو برای ذخیره اطلاعات استفاده میشوند، اما نحوه مدیریت دادهها در آنها متفاوت است.
فایلهایی مانند فایل متنی یا Excel بیشتر برای نگهداری اطلاعات ساده و محدود مناسب هستند. با افزایش حجم دادهها، تعداد کاربران یا نیاز به دسترسی همزمان، مدیریت این فایلها دشوارتر میشود و امکاناتی مانند کنترل دسترسی، حفظ یکپارچگی دادهها و اجرای جستجوهای پیچیده محدود خواهد شد.
در مقابل، دیتابیس علاوه بر ذخیرهسازی، ابزارهایی برای سازماندهی، پردازش و مدیریت دادهها ارائه میدهد. یک دیتابیس میتواند اطلاعات را در ساختارهای مشخص نگهداری کند، ارتباط بین دادهها را مدیریت کند، دسترسی کاربران را کنترل کند و کوئریهای مختلف برای بازیابی اطلاعات اجرا کند.
برای مثال، در یک فایل Excel میتوان اطلاعات مشتریان را در چند ستون ذخیره کرد؛ اما در یک دیتابیس میتوان اطلاعات مشتریان، سفارشها و تراکنشها را در جدولهای مرتبط نگهداری کرد و بدون ایجاد دادههای تکراری، اطلاعات موردنیاز را بازیابی کرد.
انواع دیتابیس
دیتابیسها براساس نحوه ذخیرهسازی، ساختار دادهها و نوع استفاده، مدلهای مختلفی دارند. انتخاب مدل مناسب به عواملی مانند نوع داده، حجم اطلاعات، سرعت دسترسی مورد نیاز و معماری اپلیکیشن بستگی دارد.
برخی از رایجترین انواع دیتابیسها عبارتند از:
- دیتابیسهای ناوبری (Navigational databases)
- دیتابیسهای رابطهای (Relational databases)
- دیتابیسهای غیررابطهای یا دیتابیسهای NoSQL (Nonrelational databases or NoSQL databases)
- دیتابیسهای شیگرا (Object-oriented databases)
- دیتابیسهای برداری (Vector databases)
- دیتابیسهای ابری (Cloud databases)
دیتابیس های ناوبری (Navigational databases)
دیتابیسهای ناوبری دادهها را در قالب رکوردهای مرتبط با یکدیگر ذخیره میکنند. در این مدل، دسترسی به داده از طریق دنبالکردن ارتباط بین رکوردها انجام میشود؛ یعنی کاربر یا برنامه باید مسیر مشخصی را برای رسیدن به اطلاعات مورد نظر طی کند. به همین دلیل این دیتابیسها «ناوبری» نامیده میشوند.
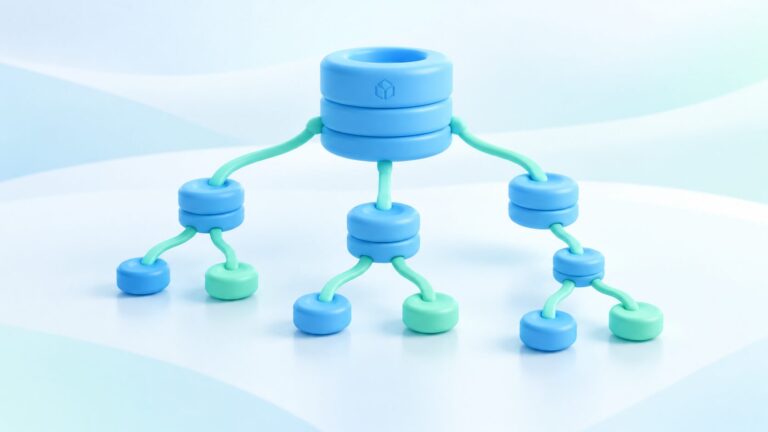
دو نوع رایج دیتابیسهای ناوبری شامل دیتابیسهای سلسلهمراتبی و دیتابیسهای شبکهای هستند:
دیتابیس های سلسله مراتبی (Hierarchical databases)
دادهها را در ساختاری شبیه به درخت از رکوردهای والد و فرزند سازماندهی میکنند. هر رکورد فرزند تنها میتواند یک رکورد والد داشته باشد، اما رکوردهای والد میتوانند چندین فرزند داشته باشند. برای رسیدن به رکورد مورد نظر، کاربران باید از بالای درخت شروع کرده و مسیر خود را به سمت پایین دنبال کنند.
دیتابیس های شبکه ای (Network databases)
عملکردی مشابه دیتابیسهای سلسلهمراتبی دارند، با این تفاوت که به هر رکورد فرزند اجازه میدهند به چندین رکورد والد متصل شود. کاربران همچنان باید از طریق رکوردهای مرتبط حرکت کنند و معمولا با استفاده از اشارهگرها (pointers) به داده مورد نظر دست پیدا میکنند.
دیتابیسهای ناوبری در سیستمهای قدیمی کاربرد زیادی داشتند، اما با توسعه دیتابیسهای رابطهای و مدل داده رابطهای (relational data model)، استفاده از آنها کاهش پیدا کرد. مدل رابطهای با حذف نیاز به تعریف مسیرهای ثابت بین دادهها، امکان جستجو و مدیریت سادهتر اطلاعات را فراهم کرد.
دیتابیس های رابطه ای (Relational databases)
دیتابیسهای رابطهای (Relational Database) دادهها را در جدولهایی شامل سطرها و ستونها ذخیره میکنند. هر جدول معمولا به یک نوع موجودیت اختصاص دارد و ارتباط میان جدولها با استفاده از روابط مشخص تعریف میشود. بیشتر این دیتابیسها از SQL (Structured Query Language) برای ایجاد، خواندن، تغییر و مدیریت دادهها استفاده میکنند.
برای مثال، در یک سیستم فروشگاهی میتوان اطلاعات مشتریان و سوابق خرید آنها را در جدولهای جداگانه ذخیره کرد. ارتباط بین این جدولها باعث میشود دادههای مرتبط بدون ایجاد نسخههای تکراری مدیریت شوند.
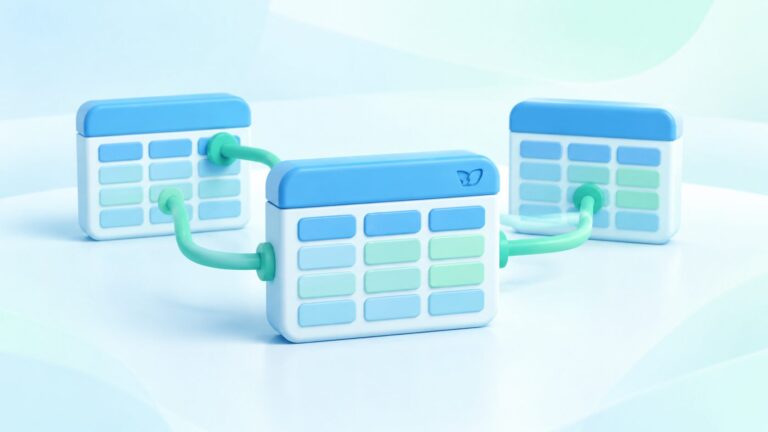
مدل رابطهای که توسط ادگار اف. کاد (Edgar F. Codd) در دهه ۱۹۷۰ معرفی شد، شیوه مدیریت دادهها را تغییر داد. در این مدل، کاربر با نوشتن کوئری SQL مشخص میکند چه دادهای نیاز دارد و دیتابیس با استفاده از روشهایی مانند ایندکسها (Indexes) مسیر مناسب برای بازیابی اطلاعات را انتخاب میکند.
مهمترین ویژگیهای دیتابیسهای رابطهای عبارتاند از:
- ذخیرهسازی دادهها در جدولهای ساختاریافته
- امکان ایجاد ارتباط بین دادههای مرتبط
- کاهش افزونگی دادهها
- پشتیبانی از کوئریهای پیچیده برای تحلیل و بازیابی اطلاعات
دیتابیسهای رابطهای همچنان یکی از پرکاربردترین مدلهای دیتابیس هستند و برای دادههای ساختاریافته مانند تراکنشهای مالی، اطلاعات کاربران و سیستمهای سازمانی استفاده میشوند.
مدلهای جدیدتری مانند دیتابیسهای NewSQL تلاش میکنند قابلیتهای مدل رابطهای را با معماری دیتابیس توزیعشده (Distributed Database Architecture) ترکیب کنند. در این معماری، دادهها میان چندین سرور دیتابیس توزیع میشوند تا امکان مقیاسپذیری بیشتر فراهم شود.
اگر برای انتخاب بین SQL و NoSQL تردید دارید، در مقاله زیر تفاوتها و کاربردهای هرکدام را بررسی کردهایم.
مقایسه SQL و NoSQL، کدام را انتخاب کنیم؟
دیتابیس های غیررابطه ای (Nonrelational databases) یا دیتابیس های NoSQL
دیتابیسهای NoSQL برای ذخیره دادههایی طراحی شدهاند که ساختار ثابت و جدولی ندارند. برخلاف دیتابیسهای رابطهای که دادهها را در جدولهای مشخص ذخیره میکنند، این مدلها از ساختارهای مختلفی مانند سند، گراف، کلید / مقدار و ستونگسترده برای مدیریت دادهها استفاده میکنند.
این دیتابیسها معمولا برای دادههای بدون ساختار و نیمهساختاریافته مانند متن، تصاویر، دادههای شبکههای اجتماعی و اطلاعات تولیدشده توسط اپلیکیشنها کاربرد دارند. انعطافپذیری مدل داده در NoSQL باعث میشود تغییر ساختار اطلاعات بدون بازطراحی کامل دیتابیس سادهتر باشد.
مدلهای رایج دیتابیسهای NoSQL شامل موارد زیر هستند:
دیتابیس های گراف (Graph databases)
دادهها را به شکل گرهها (nodes) و یالها (edges) ذخیره میکنند. گرهها موجودیتها و یالها ارتباط میان آنها را نمایش میدهند. این مدل برای تحلیل روابط پیچیده، مانند ارتباط کاربران در شبکههای اجتماعی یا بررسی ارتباط میان دادههای مختلف، کاربرد دارد.
دیتابیس های سندگرا (Document databases)
دادهها را به شکل سند ذخیره میکنند و از قالبهایی مانند JSON , XML و BSON پشتیبانی میکنند. دیتابیسهای سندگرا در سیستمهای مدیریت محتوا کاربرد گستردهای دارند.
دیتابیس های کلید / مقدار (Key-value databases)
دادهها را در قالب جفتهای کلید / مقدار نگهداری میکنند. کلید به عنوان شناسه یکتا برای هر داده عمل میکند و مقدار، اطلاعات مرتبط با آن را ذخیره میکند. این مدل برای مواردی مانند ذخیره نشستهای کاربر، کش دادهها و اطلاعات سبد خرید کاربرد دارد.
دیتابیس های ستون گسترده (Wide-column databases)
دادهها را در ساختاری شامل سطر و ستون ذخیره میکنند، اما برخلاف دیتابیسهای رابطهای، هر سطر میتواند مجموعه ستونهای متفاوتی داشته باشد. این مدل برای مدیریت حجم زیادی از دادهها در سیستمهای توزیعشده و پردازش داده از چندین منبع استفاده میشود.
برای آشنایی کامل با نحوه کار NoSQL و بررسی مزایا، معایب و کاربردهای آن، مقاله NoSQL را مطالعه کنید.
NoSQL چیست؟
دیتابیس های شی گرا (Object-oriented databases)
دیتابیسهای شیگرا (Object-Oriented Databases) دادهها را به شکل شی (Object) ذخیره میکنند و ساختار آنها با مفاهیمی مانند کلاس، ویژگی و متد در برنامهنویسی شیگرا هماهنگ است. در این مدل، داده و رفتار مرتبط با آن میتوانند در یک ساختار واحد نگهداری شوند.
هر شی یک موجودیت مشخص را نمایش میدهد و شامل ویژگیهایی (Attributes) برای ذخیره اطلاعات و متدهایی (Methods) برای تعریف رفتار مرتبط با آن موجودیت است. برای مثال، در یک سیستم مدیریت کاربران، شی مربوط به یک کاربر میتواند اطلاعاتی مانند نام و ایمیل را نگهداری کند و متدهایی برای انجام عملیات مرتبط با همان کاربر داشته باشد.
این مدل دیتابیس در دهه ۱۹۹۰ و همزمان با گسترش زبانهای برنامهنویسی شیگرا بیشتر مورد توجه قرار گرفت. در بسیاری از برنامههای شیگرا، تبدیل اشیا به ساختار جدولی دیتابیسهای رابطهای از طریق ORM (Object-Relational Mapping) انجام میشود. دیتابیسهای شیگرا با ذخیره مستقیم اشیا، ارتباط نزدیکتری بین کد برنامه و لایه ذخیرهسازی داده ایجاد میکنند.
دیتابیس های برداری (Vector databases)
دیتابیسهای برداری (Vector Databases) دادهها را به شکل بردارهای عددی (Vectors) ذخیره میکنند. این بردارها نمایشی عددی از ویژگیهای یک داده هستند و امکان مقایسه میزان شباهت بین دادههای مختلف را فراهم میکنند.
برای مثال، یک مدل هوش مصنوعی میتواند یک تصویر، متن، فایل صوتی یا ویدیو را به یک بردار با ابعاد بالا (High-Dimensional Vector) تبدیل کند. دیتابیس برداری با مقایسه این بردارها میتواند دادههای مشابه را سریعتر پیدا کند.
این دیتابیسها در کاربردهایی مانند یادگیری ماشین، پردازش زبان طبیعی (NLP) و سیستمهای جستجوی هوشمند استفاده میشوند. یکی از کاربردهای مهم آنها در معماری RAG (Retrieval-Augmented Generation) است؛ جایی که مدلهای زبانی بزرگ (LLMs) برای پاسخگویی بهتر، اطلاعات موردنیاز را از یک منبع خارجی مانند پایگاه دانش بازیابی میکنند.
اگر میخواهید با ساختار، نحوه ذخیرهسازی بردارها و کاربرد دیتابیسهای برداری در هوش مصنوعی آشنا شوید، مقاله زیر را بخوانید.
دیتابیس برداری چیست؟
دیتابیس های ابری (Cloud databases)
دیتابیس ابری (Cloud Database) نوعی دیتابیس است که روی زیرساخت ابری اجرا و مدیریت میشود. در این مدل، هر نوع دیتابیسی مانند رابطهای (Relational)، غیررابطهای (NoSQL) یا سایر مدلها میتواند در محیط ابری استفاده شود.
دیتابیسهای ابری معمولا به دو شکل ارائه میشوند:
دیتابیس خودمدیریت شده (Self-Managed)
در این مدل، دیتابیس روی یک زیرساخت ابری اجرا میشود، اما مسئولیت مدیریت آن بر عهده تیم فنی است. کارهایی مانند نصب و پیکربندی دیتابیس، تنظیم دسترسیها، انجام بهروزرسانیها، تهیه نسخه پشتیبان، مانیتورینگ عملکرد و رفع مشکلات احتمالی توسط تیم داخلی انجام میشود. این مدل کنترل بیشتری روی تنظیمات دیتابیس در اختیار تیم قرار میدهد، اما به دانش فنی و زمان بیشتری برای نگهداری نیاز دارد.
دیتابیس به عنوان سرویس (DBaaS)
در این مدل، دیتابیس به صورت یک سرویس آماده روی زیرساخت ابری ارائه میشود و تیم فنی نیازی به درگیر شدن با کارهایی مانند نصب، پیکربندی، بهروزرسانی و نگهداری زیرساخت دیتابیس ندارد. ارائهدهنده سرویس وظایفی مانند پشتیبانگیری، مانیتورینگ، مدیریت منابع و برخی تنظیمات امنیتی را انجام میدهد و کاربران میتوانند از طریق ابزارها و APIهای موجود، دیتابیس موردنیاز خود را ایجاد و مدیریت کنند.
یکی از مزیتهای اصلی دیتابیسهای ابری، امکان مقیاسپذیری سریعتر نسبت به دیتابیسهای سنتی درونسازمانی (On-Premises) است. سازمانها میتوانند با تغییر نیازهای پروژه، منابع پردازشی و فضای ذخیرهسازی را افزایش یا کاهش دهند.
اگر به دیتابیسی مقیاسپذیر، امن و قابل مدیریت برای اپلیکیشنهای خود نیاز دارید، سرویس دیتابیس ابری لیارا را بررسی کنید.
خرید دیتابیس ابری
انواع دیگر دیتابیس ها
در کنار مدلهای رایج مانند رابطهای، NoSQL و برداری، دیتابیسهایی وجود دارند که برای نیازهای خاص طراحی شدهاند. این مدلها معمولا با هدف پشتیبانی از چند نوع داده یا افزایش سرعت دسترسی به اطلاعات استفاده میشوند.
دیتابیس های چندمدلی (Multimodel Databases)
این دیتابیسها امکان ذخیره و مدیریت چند نوع مدل داده را در یک سیستم فراهم میکنند. برای مثال، یک دیتابیس چندمدلی میتواند همزمان دادههای ساختاریافته، JSON , XML، متنی یا مکانی را در یک نمونه دیتابیس (Database Instance) مدیریت کند.
دیتابیس های درون حافظه ای (In-Memory Databases)
این مدل دادهها را به جای دیسک، در حافظه اصلی (RAM) نگهداری میکند تا سرعت خواندن و پردازش افزایش پیدا کند. به همین دلیل در کاربردهایی مانند کش دادهها، تحلیل لحظهای و سیستمهایی که به پاسخ سریع نیاز دارند استفاده میشود. محدودیت اصلی این دیتابیسها ظرفیت کمتر حافظه نسبت به فضای ذخیرهسازی معمولی و وابستگی بیشتر به RAM است.
تفاوت دیتابیس با Data Lake و Data Warehouse
دیتابیس تنها یکی از اجزای معماری داده است. سازمانها بسته به نوع نیاز خود، ممکن است در کنار دیتابیس از ابزارهایی مانند دیتا لیک و دیتا وارهوس نیز استفاده کنند.
- دیتابیس (Database): برای ذخیره، مدیریت و بازیابی دادههای موردنیاز اپلیکیشنها استفاده میشود و معمولا برای پردازشهای سریع، تراکنشها و کوئریهای روزمره به کار میرود.
- دیتا لیک (Data Lake): برای نگهداری حجم زیادی از دادههای خام، ساختاریافته و بدون ساختار طراحی شده است و بیشتر در تحلیل داده، پردازشهای گسترده و پروژههای هوش مصنوعی کاربرد دارد.
- دیتا وارهوس (Data Warehouse): دادهها را از منابع مختلف جمعآوری و آماده میکند تا برای گزارشگیری، تحلیل کسبوکار و تصمیمگیری استفاده شوند.
- دیتا لیکهاوس (Data Lakehouse): معماری ترکیبی است که تلاش میکند انعطافپذیری دیتا لیک را با قابلیتهای تحلیلی دیتا وارهوس در یک محیط واحد ارائه دهد.
دیتابیس چگونه کار می کند؟
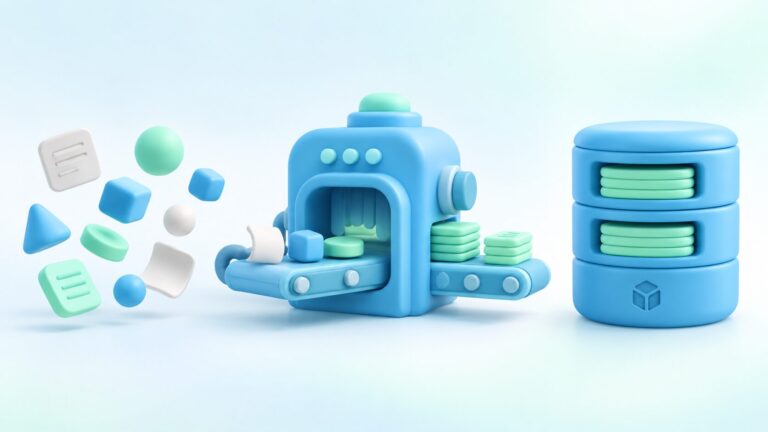
در سطح کلی، یک سیستم دیتابیس دارای ۲ بخش اصلی است: سیستم ذخیرهسازی داده که دادهها را به صورت فیزیکی یا منطقی نگهداری میکند و سیستم مدیریت دیتابیس (database management system) یا DBMS که به کاربران امکان میدهد با مجموعه دادههای ذخیرهشده تعامل داشته باشند.
همچنین میتوان اجزای یک سیستم دیتابیس را با جزئیات بیشتری بررسی کرد تا درک دقیقتری از نحوه عملکرد و سازوکار یک دیتابیس به دست آورد.
سخت افزار دیتابیس
دیتابیس برای ذخیره و پردازش دادهها به منابع سختافزاری نیاز دارد، اما برای اجرای آن به سختافزار اختصاصی و خاصی وابسته نیست. بیشتر سیستمهای دیتابیس به صورت نرمافزاری روی سرور، کامپیوتر یا زیرساخت ابری اجرا میشوند.
در این معماری، سختافزار منابعی مانند پردازنده، حافظه و فضای ذخیرهسازی را فراهم میکند و نرمافزار دیتابیس وظیفه مدیریت و سازماندهی دادهها را بر عهده دارد. نحوه ذخیرهسازی نیز به نوع دیتابیس بستگی دارد؛ برای مثال، دیتابیسهای رابطهای دادهها را در جدولها و دیتابیسهای گرافی آنها را به شکل گراف نگهداری میکنند.
در سیستمهای مدرن، معمولا سرور اپلیکیشن و سرور دیتابیس از یکدیگر جدا هستند. این معماری چندلایه (Multitier Architecture) به هر بخش اجازه میدهد مستقل از دیگری مقیاسپذیر شود و در صورت بروز مشکل در یک لایه، تاثیر کمتری روی بخشهای دیگر داشته باشد.
مدل های داده و مدل های دیتابیس
مدل داده (data model) یک نمایش بصری از یک سیستم اطلاعاتی است. این مدلها ابزارهای مفهومی هستند که مدیران دیتابیس و طراحان از آنها برای درک نوع دادههای مورد نیاز، روابط بین نقاط داده و بهترین روش سازماندهی اطلاعات استفاده میکنند.
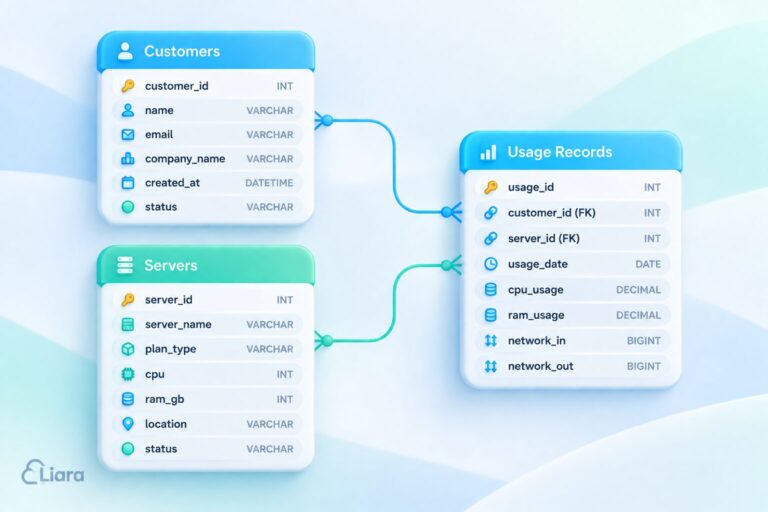
مدل داده به انتخاب مدل مناسب دیتابیس کمک میکند؛ یعنی نحوه پیادهسازی عملی سیستم دیتابیس، از جمله نیازمندیهای فنی و قالبهای ذخیرهسازی را مشخص میکند. برای مثال، مدل منطقی داده قبلی میتواند به یک دیتابیس رابطهای با ساختاری مشابه نمونه زیر منجر شود:
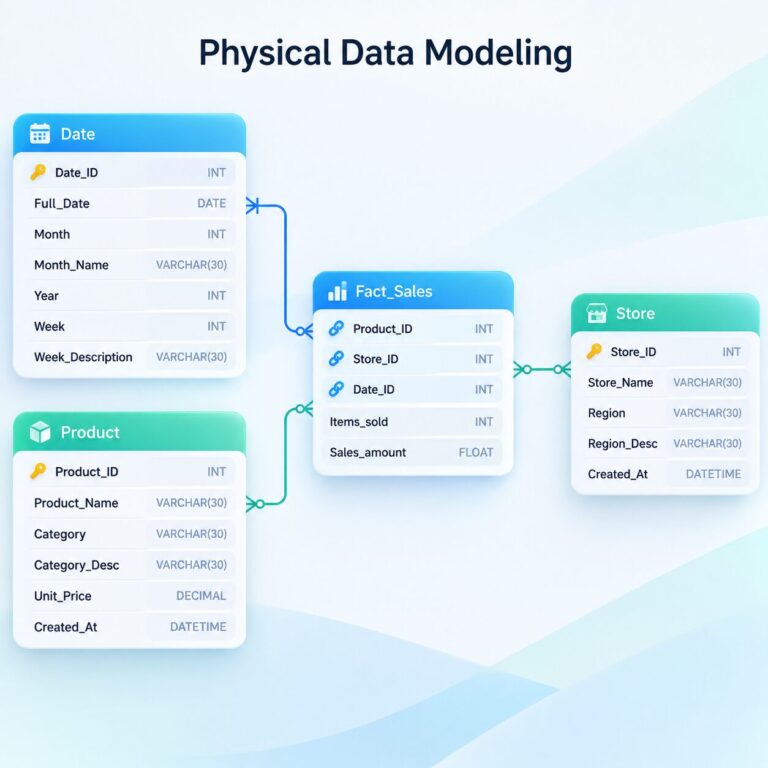
اسکیمای دیتابیس چیست؟
اسکیمای دیتابیس (Database Schema) ساختاری است که مشخص میکند دادهها چگونه در یک دیتابیس سازماندهی و ذخیره شوند. به بیان ساده، اسکیما مجموعهای از قوانین و تعریفهاست که ساختار دادهها را مشخص میکند.
در یک دیتابیس رابطهای، اسکیما مواردی مانند موارد زیر را تعریف میکند:
- نام جدولها
- فیلدهای هر جدول
- نوع دادهها
- ارتباط بین جدولها
اسکیما میتواند به شکل نمودارهای بصری نمایش داده شود یا با استفاده از SQL و سایر ابزارهای توسعه تعریف شود. روش پیادهسازی آن به نوع دیتابیس و معماری سیستم بستگی دارد.
تمام دیتابیسهای رابطهای از اسکیما استفاده میکنند. در دیتابیسهای غیررابطهای نیز وضعیت متفاوت است؛ برخی مدلها اسکیما دارند، برخی بدون اسکیما طراحی شدهاند و برخی دیگر امکان استفاده از اسکیما را به صورت اختیاری فراهم میکنند.
سیستم های مدیریت دیتابیس (DBMSs)
سیستم مدیریت دیتابیس (Database Management System) یا DBMS نرمافزاری است که بین کاربران، اپلیکیشنها و دیتابیس قرار میگیرد و امکان مدیریت و کار با دادهها را فراهم میکند.
DBMS وظایفی مانند ایجاد ساختار دیتابیس، مدیریت فرادادهها (Metadata)، اجرای کوئریها و انجام عملیاتهایی مانند افزودن، تغییر یا حذف دادهها را بر عهده دارد. همچنین بسیاری از سیستمهای مدیریت دیتابیس امکاناتی مانند کنترل دسترسی، ثبت فعالیت کاربران و پایش عملکرد دیتابیس را ارائه میدهند.
DBMSها بر اساس نوع دیتابیسی که مدیریت میکنند، مدلهای مختلفی دارند. برای مثال:
- RDBMS (Relational Database Management System): برای مدیریت دیتابیسهای رابطهای مانند MySQL و PostgreSQL استفاده میشود.
- OODBMS (Object-Oriented Database Management System): برای مدیریت دیتابیسهای شیگرا طراحی شده است.
برخی از سیستمهای مدیریت دیتابیس پرکاربرد عبارتاند از:
- MySQL: یک RDBMS متنباز که در بسیاری از وبسایتها و اپلیکیشنهای آنلاین استفاده میشود.
- PostgreSQL: دیتابیسی شناختهشده برای قابلیت توسعهپذیری و پشتیبانی از تراکنشهای قابل اعتماد.
- Microsoft SQL Server: یکی از گزینههای رایج در سازمانهایی که از اکوسیستم مایکروسافت استفاده میکنند.
- Oracle Database: یک DBMS چندمدلی که امکان مدیریت دادههای ساختاریافته و بدون ساختار را فراهم میکند.
- IBM Db2: یک سیستم دیتابیس سازمانی با قابلیتهایی مانند مدیریت داده، تحلیل و پشتیبانی از کاربردهای هوش مصنوعی.
زبان های دیتابیس (Database Languages)
زبانهای دیتابیس ابزارهایی هستند که برای تعامل با دادهها و مدیریت عملیات مختلف در دیتابیس استفاده میشوند. توسعهدهندگان و مدیران دیتابیس با استفاده از این زبانها میتوانند دادهها را جستجو، اضافه، تغییر یا حذف کنند و ساختار دیتابیس را مدیریت کنند.
رایجترین زبان دیتابیس، SQL (Structured Query Language) است که در بیشتر دیتابیسهای رابطهای استفاده میشود. SQL امکان تعریف ساختار داده، اجرای کوئریها، مدیریت دسترسیها و انجام تحلیلهای مختلف روی دادهها را فراهم میکند.
علاوه بر SQL، زبانهای دیگری نیز برای مدلهای خاص دیتابیس طراحی شدهاند. برای مثال:
- OQL (Object Query Language): برای کار با دیتابیسهای شیگرا استفاده میشود.
- XQuery: برای جستجو و پردازش دادههای XML کاربرد دارد.
- MQL (MongoDB Query Language): برای تعامل با دیتابیس MongoDB استفاده میشود.
- CQL (Cassandra Query Language): برای مدیریت دادهها در Apache Cassandra طراحی شده است.
چرا دیتابیس ها اهمیت دارند؟
دیتابیسها بخش مهمی از بسیاری از فناوریهایی هستند که امروزه افراد به آنها وابستهاند؛ از اپلیکیشنهای بانکی که تراکنشهای مالی را در دیتابیسهای رابطهای ثبت و ردیابی میکنند تا دستیارهای هوش مصنوعی که برای افزایش دقت از دیتابیسهای برداری استفاده میکنند. دیتابیسها کاربرد گستردهای دارند، زیرا نقش مهمی در پشتیبانی از موارد زیر ایفا میکنند:
- قابلیت استفاده از دادهها (Data usability)
- یکپارچگی دادهها (Data integrity)
- امنیت دادهها و انطباق با الزامات (Data security and compliance)
قابلیت استفاده از داده ها
داده زمانی ارزش ایجاد میکند که بتوان به آن دسترسی داشت و از آن برای تصمیمگیری استفاده کرد. بسیاری از سازمانها حجم زیادی از اطلاعات را در اختیار دارند، اما پراکندگی دادهها، نبود ساختار مشخص یا وجود جزیرههای داده (Data Silos) باعث میشود بخش زیادی از این اطلاعات قابل استفاده نباشد.
دیتابیسها با ذخیرهسازی متمرکز و سازماندهی دادهها، دسترسی به اطلاعات موردنیاز را سادهتر میکنند. آنها میتوانند فرایندهایی مانند ثبت تراکنشها، ذخیره رویدادها و مدیریت دادههای اپلیکیشنها را به شکل خودکار انجام دهند.
وقتی دادهها ساختار مشخصی داشته باشند و بهسادگی قابل بازیابی باشند، سازمانها میتوانند از آنها برای تصمیمگیری بهتر، تحلیل کسبوکار، توسعه سرویسهای جدید و اجرای پروژههای هوش مصنوعی و یادگیری ماشین استفاده کنند.
یکپارچگی داده ها
دیتابیسها در مقایسه با روشهای دستی مانند فایلهای جدولی، کنترل بیشتری روی کیفیت و صحت دادهها فراهم میکنند. در روشهای سنتی، احتمال ایجاد دادههای تکراری، خطاهای انسانی و ناسازگاری بین نسخههای مختلف اطلاعات بیشتر است.
با مدیریت متمرکز دادهها، دیتابیسها امکان اعمال قوانین مشخص برای قالببندی، اعتبارسنجی و پاکسازی اطلاعات را فراهم میکنند. همچنین به جای نگهداری چند نسخه جداگانه از یک داده، کاربران و اپلیکیشنها میتوانند از یک منبع داده مشترک استفاده کنند.
این ساختار باعث میشود اطلاعات برای کاربران، سرویسها و APIها قابل اعتمادتر باشد و سازمانها بتوانند تصمیمگیری و پردازش داده را بر اساس اطلاعات دقیقتری انجام دهند.
امنیت داده ها و انطباق با مقررات
سازمانها بسته به حوزه فعالیت و محل ارائه خدمات، باید از قوانین مربوط به حفاظت از دادهها و حریم خصوصی پیروی کنند. مقرراتی مانند HIPAA در حوزه سلامت آمریکا و GDPR در اتحادیه اروپا، الزامات مشخصی برای نحوه ذخیره و مدیریت اطلاعات تعیین کردهاند.
علاوه بر الزامات قانونی، محافظت از دادهها برای حفظ اعتماد کاربران و جلوگیری از خسارتهای ناشی از دسترسی غیرمجاز اهمیت دارد. نشت اطلاعات میتواند هزینههای مالی، اختلال در سرویسها و آسیب به اعتبار سازمان را به همراه داشته باشد.
دیتابیسها با قابلیتهایی مانند کنترل دسترسی مبتنی بر نقش (Role-Based Access Control یا RBAC)، رمزنگاری و ثبت فعالیت کاربران، به سازمانها کمک میکنند دسترسی به اطلاعات را مدیریت کرده و امنیت دادهها را افزایش دهند.
نقش دیتابیس ها در توسعه پروژه های هوش مصنوعی
۷۵ درصد از مدیران عامل معتقدند که داشتن پیشرفتهترین هوش مصنوعی مولد، در آینده به یکی از عوامل تعیینکننده مزیت رقابتی سازمانها تبدیل خواهد شد. برای پشتیبانی از چنین سیستمهای هوش مصنوعی پیشرفتهای، سازمانها باید بتوانند حجم زیادی از دادههای ساختاریافته و بدون ساختار را ذخیره، مدیریت و حاکمیت کنند. این کار تنها با استفاده از سیستمهای دیتابیس مناسب امکانپذیر است.
انواع مختلف دیتابیسها میتوانند به روشهای متفاوتی از پروژههای هوش مصنوعی و یادگیری ماشین پشتیبانی کنند. برای مثال، دیتابیسهای برداری معمولا برای پیادهسازی چارچوبهای تولید تقویتشده با بازیابی (retrieval augmented generation) یا RAG استفاده میشوند که میتوانند به کاهش توهمات هوش مصنوعی (AI hallucinations) کمک کنند. دیتابیسهای کلید-مقدار (key-value databases) میتوانند سرعت بازیابی و پردازش دادهها را افزایش دهند. دیتابیسهای درونحافظهای (in-memory databases) نیز برای کشکردن دادهها و تحلیلهای جریانی (streaming analytics) کاربرد دارند.
نکات مهم در انتخاب دیتابیس
عوامل مختلفی میتوانند بر انتخاب نوع دیتابیس برای یک پروژه یا هدف مشخص تاثیر بگذارند. مهمترین این عوامل عبارتند از:
- نوع داده (Type of data): هر نوع دیتابیسی برای مدیریت برخی از دادهها عملکرد بهتری دارد. برای مثال، یک دیتابیس گرافی برای نمایش و تحلیل روابط میان دادهها معمولا انتخاب مناسبتری نسبت به یک دیتابیس SQL است.
- هدف استفاده (Purpose): مدلهای مختلف دیتابیس برای کاربردهای متفاوت طراحی شدهاند. برای مثال، یک دیتابیس برداری اغلب گزینه مناسبی برای پیادهسازی چارچوب RAG است.
- نیازمندیهای عملکردی (Performance requirements): اگر یک اپلیکیشن به صورت مداوم دادهها را در لحظه دریافت میکند، دیتابیس باید برای اجرای سریع کوئریها بهینه شده باشد. اما اگر هدف سازمان فقط ذخیره دادهها پیش از انتقال آنها به یک دیتا وارهوس باشد، سرعت پردازش ممکن است اهمیت کمتری داشته باشد.
- هزینه (Price): حجم دادهای که سازمان نیاز به ذخیرهسازی آن دارد، قالب دادهها و نیازمندیهای عملکردی، همگی میتوانند روی هزینه دیتابیس تاثیر بگذارند.
- مقیاسپذیری (Scalability): برخی دیتابیسها تنها از مقیاسپذیری عمودی پشتیبانی میکنند؛ یعنی برای افزایش ظرفیت باید منابع بیشتری به یک سرور یا دستگاه موجود اضافه شود. در مقابل، برخی دیتابیسها قابلیت مقیاسپذیری افقی دارند و میتوان با اضافهکردن سرورهای بیشتر، دیتابیس را در یک معماری توزیعشده گسترش داد.
جمع بندی
دیتابیس یکی از اجزای اصلی زیرساخت نرمافزارهای مدرن است که امکان ذخیرهسازی، سازماندهی و استفاده از دادهها را فراهم میکند. از دیتابیسهای رابطهای برای مدیریت دادههای ساختاریافته تا مدلهایی مانند NoSQL، برداری و ابری برای نیازهای جدید، هر نوع دیتابیس برای سناریوهای مشخصی طراحی شده است.
انتخاب دیتابیس مناسب به عواملی مانند نوع داده، حجم اطلاعات، نیازهای عملکردی، امنیت و مسیر رشد پروژه بستگی دارد. زمانی که معماری داده به درستی طراحی شود، دیتابیس میتواند به توسعه سرویسهای قابل اعتماد، تصمیمگیری بهتر و ساخت سیستمهای مقیاسپذیر کمک کند.