آنچه در این مقاله میخوانید
Chroma چیست؟ پایگاه داده متن باز ChromaDB برای هوش مصنوعی
 المیرا سادات اسدی
۲۵ مهر ۱۴۰۵
خلاصه کنید:
فرض کنید کاربری در مرکز راهنمای سایت میپرسد: “رمز عبورم را فراموش کردهام”. اگر جستجو فقط بر تطابق واژهها تکیه کند، ممکن است راهنمای “بازیابی دسترسی به حساب” را پیدا نکند. جستجوی معنایی کمک میکند مطالب مرتبط، حتی با عبارتهای متفاوت، پیدا شوند. Chroma یک دیتابیس برداری متنباز برای ساخت چنین قابلیتهایی است.
در این مقاله با نحوه کار، کاربردها و روشهای راهاندازی Chroma آشنا میشویم.
در ادامه میخوانید:
- Chroma چیست؟
- Chroma چگونه کار میکند؟
- مهمترین قابلیتهای Chroma
- Chroma چه کاربردهایی دارد؟
- نقش Chroma در سیستمهای RAG چیست؟
- Chroma برای چه پروژههایی مناسب است؟
- روشهای اجرای Chroma
- آموزش شروع کار با Chroma در پایتون
- راهاندازی Chroma با One-Click App لیارا
- جمعبندی
- سوالات متداول درباره Chroma
Chroma چیست؟
Chroma که با نام ChromaDB هم شناخته میشود، یک دیتابیس برداری متنباز برای ذخیره، مدیریت و جستجوی بردارهای عددی (Embedding) است. این بردارها از دادههایی مانند متن و تصویر تولید میشوند و امکان مقایسه شباهت آنها را فراهم میکنند.
برای مثال، در یک برنامه پرسشوپاسخ میتوان بردار بخشهای مختلف مستندات را همراه متن آنها در Chroma ذخیره کرد تا برنامه هنگام دریافت سوال کاربر، بخشهای مرتبط را پیدا کند و برای پاسخگویی در اختیار مدل زبانی قرار دهد.
نقش Chroma در چنین برنامهای، نگهداری و بازیابی اطلاعات است؛ تولید پاسخ را مدل زبانی انجام میدهد که با مجوز Apache 2.0 منتشر میشود و میتوانید آن را روی کامپیوتر شخصی، سرور یا زیرساخت ابری اجرا کنید. کلاینتهای پایتون و جاوااسکریپت نیز امکان اتصال برنامه به Chroma و انجام عملیات ذخیرهسازی و جستجو را فراهم میکنند.
جستجوی معنایی و بازیابی اطلاعات پروژه خود را با Chroma روی لیارا راهاندازی کنید.
✅ نصب از بخش برنامههای آماده✅ مشاهده لاگها و مصرف منابع✅ دسترسی به مستندات
خرید و راهاندازی Chroma لیارا
Chroma چگونه کار می کند؟
برای درک نحوه کار Chroma، یک سامانه جستجو در مستندات محصول را در نظر بگیرید. در این سامانه، محتوای اسناد ابتدا آماده و به بردار تبدیل میشود، سپس در Chroma قرار میگیرد تا بتوان بخشهای مرتبط با پرسش کاربران را بازیابی کرد. این فرایند چهار مرحله اصلی دارد.
آمادهسازی متنها
پیش از ذخیره دادهها، باید محتوای قابل جستجو را از منابع اصلی استخراج کنید؛ برای مثال، متن فایلهای PDF را بیرون بکشید یا بخشهای اضافی صفحات وب، مانند منوها، را کنار بگذارید. سپس اسناد طولانی به بخشهای کوچکتر و معنادار تقسیم میشوند؛ فرایندی که به آن تقسیمبندی متن (Chunking) میگویند.
به این ترتیب، یک راهنمای چندصفحهای میتواند به بخشهایی مانند “ایجاد حساب”، “بازیابی دسترسی” و “تنظیمات پرداخت” تبدیل شود تا هنگام جستجو، همان قسمت مورد نیاز بازیابی شود. آمادهسازی و تقسیمبندی محتوا در برنامه یا ابزارهای پردازش اسناد انجام میشود و صرف افزودن فایل به Chroma، این مراحل را خودکار انجام نمیدهد.
تبدیل داده به Embedding
پس از آمادهسازی محتوا، مدل Embedding هر بخش از متن را به فهرستی از عددها تبدیل میکند که نمایشی از ویژگیهای معنایی آن است. این نمایش عددی کمک میکند متنهای مرتبط، حتی با واژههای متفاوت، در فضای برداری به یکدیگر نزدیک باشند.
برای تولید این بردارها میتوانید یک تابع Embedding به Collection متصل کنید تا هنگام افزودن متن فراخوانی شود، یا بردارها را با ابزار و مدل دلخواه خود بسازید و مستقیما به Chroma بدهید. انتخاب مدل باید با زبان محتوا و نوع جستجوی مورد انتظار هماهنگ باشد، چون کیفیت بردارها بر مرتبطبودن نتایج اثر میگذارد.
ذخیره اطلاعات در Collection
Chroma دادهها را در مجموعههایی به نام Collection نگهداری میکند. هر رکورد در این مجموعه یک شناسه یکتا دارد و میتواند علاوه بر بردار، شامل متن و اطلاعات تکمیلی یا متادیتا (Metadata) باشد. برای نمونه، هنگام ذخیره بخشهای یک مقاله میتوانید موضوع، زبان، نشانی منبع و تاریخ انتشار را نیز ثبت کنید تا بعدا جستجو را به دسته مشخصی از مطالب محدود کنید یا منبع هر نتیجه را نمایش دهید.
Collection ابزاری برای سازماندهی این رکوردهاست و اگرچه از این نظر به جدول شباهت دارد، ساختار و کاربرد آن با جدول در دیتابیس رابطهای متفاوت است.
جستجوی بردارهای مشابه
وقتی کاربر سوالی میپرسد، پرسش او نیز با مدل Embedding سازگار با بردارهای اسناد به بردار تبدیل میشود. Chroma سپس براساس معیار فاصله تنظیمشده، بردارهای نزدیکتر را پیدا میکند و متن یا اطلاعات همراه آنها را برمیگرداند. برای مثال، پرسش “چطور دوباره وارد حسابم شوم؟” میتواند به راهنمای بازیابی دسترسی برسد، حتی اگر همین عبارت در متن راهنما وجود نداشته باشد.
میزان مرتبطبودن نتایج به مدل Embedding، کیفیت محتوا و نحوه تقسیمبندی اسناد وابسته است؛ بنابراین نزدیکبودن یک بردار به پرسش، بهتنهایی به معنی وجود پاسخ درست و کافی در آن سند نیست.
مهمترین قابلیت های Chroma
Chroma ابزارهایی برای مدیریت دادهها در کنار جستجوی شباهت ارائه میدهد تا توسعهدهنده مجبور نباشد همه این بخشها را جداگانه بسازد.
- فیلترکردن نتایج با متادیتا: امکان محدود کردن جستجو به بخش مشخصی از دادهها (مثلاً فقط مستندات فارسی یا مقالات مربوط به پرداخت). در مرکز پشتیبانی کمک میکند سوال مربوط به نسخه جدید محصول، فقط میان مستندات همان نسخه جستجو شود و مرتبطبودن معنایی با شرایط برنامه ترکیب شود.
- فیلتر براساس محتوای متن: علاوه بر شباهت برداری، امکان فیلتر کردن رکوردها بر اساس محتوای متنی وجود دارد (مثلاً محدود کردن نتایج به متنهایی که عبارت مشخصی در آنها هست). این قابلیت وقتی مفید است که وجود نام محصول، کد یا اصطلاح خاص اهمیت داشته باشد (البته معادل موتور کامل جستجوی ترکیبی و رتبهبندی پیشرفته نیست).
- افزودن و بهروزرسانی دادهها: امکان افزودن، ویرایش و حذف رکوردها فراهم است. عملیات upsert رکورد موجود را بهروزرسانی میکند و در صورت نبود شناسه، آن را اضافه میکند. مثلاً پس از تغییر راهنمای محصول میتوان بخشهای مربوط را بهروزرسانی کرد (البته برنامه باید تغییرات را از منبع اصلی به Chroma منتقل کند).
- اتصال به ابزارهای توسعه هوش مصنوعی: امکان استفاده مستقیم از API و کلاینتهای Chroma یا یکپارچهسازی با ابزارهایی مانند LangChain و LlamaIndex وجود دارد. این ابزارها به اتصال مراحل دریافت اسناد، پردازش متن، بازیابی و فراخوانی مدل زبانی کمک میکنند و برای تیمهایی که میخواهند Chroma را در جریان توسعه فعلی خود به کار بگیرند مفید است.
Pghero چیست؟ بررسی ابزار مانیتورینگ پیشرفته برای PostgreSQL
Pghero چیست؟
Chroma چه کاربردهایی دارد؟
هرجا پیداکردن دادههای مشابه از نظر معنا اهمیت داشته باشد، میتوان استفاده از Chroma را بررسی کرد. چند نمونه از این کاربردها را در ادامه میبینید.
۱. ساخت چتبات روی مستندات اختصاصی
فرض کنید میخواهید چتبات سایت به سوالهای کاربران درباره محصولات شما پاسخ دهد. در این حالت، برنامه میتواند پیش از تولید پاسخ، بخشهای مرتبط راهنماها و سوالات متداول را از Chroma دریافت کند و در اختیار مدل زبانی بگذارد. با این روش، پاسخگویی بر محتوای اختصاصی کسبوکار تکیه میکند؛ هرچند کیفیت نهایی پاسخ همچنان به درستی منابع و طراحی برنامه وابسته است.
۲. جستجوی معنایی در مقالهها و فایلها
کاربران همیشه اصطلاح دقیق موجود در اسناد را نمیدانند. مثلاً ممکن است عبارت “سایتم دیر باز میشود” را جستجو کنند، در حالی که عنوان راهنما “کاهش زمان پاسخ سرور” باشد. جستجوی معنایی میتواند این فاصله را کمتر کند و چنین قابلیتی برای مراکز راهنما، آرشیو مقالهها و پایگاه دانش داخلی سازمان بسیار کاربردی است.
۳. پیشنهاد محتوای مرتبط
با تبدیل توضیح مقالهها یا محصولات به بردار، میتوان موارد نزدیک به محتوای فعلی را پیدا کرد. برای نمونه، کنار یک راهنمای استقرار برنامه، آموزشهای مرتبط پیشنهاد شوند. البته ساخت یک سیستم پیشنهاددهنده شخصیسازیشده معمولاً به اطلاعات و منطق بیشتری نیاز دارد و شباهت محتوا تنها یکی از ورودیهای آن است.
۴. بازیابی اطلاعات برای دستیارهای هوشمند
یک دستیار سازمانی میتواند یادداشتها یا اطلاعات مجاز مربوط به یک کاربر را ذخیره و هنگام نیاز بازیابی کند. در این سناریو، Chroma بخش بازیابی حافظه را پوشش میدهد. با این حال، برنامه همچنان باید مشخص کند چه چیزی ذخیره شود، چه زمانی حذف شود و هر کاربر به کدام دادهها دسترسی داشته باشد.
نقش Chroma در سیستمهای RAG چیست؟
RAG مخفف Retrieval-Augmented Generation است و معمولا به “تولید تقویتشده با بازیابی” ترجمه میشود. در این روش، برنامه پیش از تولید پاسخ، اطلاعات مرتبط را از منابع بیرونی پیدا میکند و در اختیار مدل زبانی قرار میدهد.
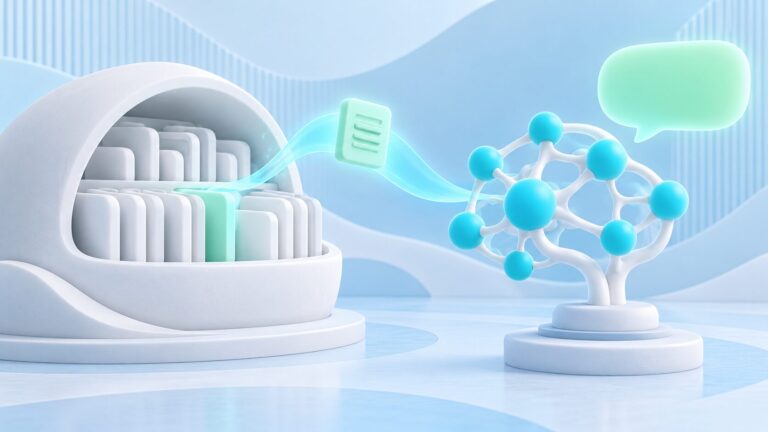
در یک پیادهسازی معمول با Chroma، روند کار چنین است:
- متن مستندات استخراج و به بخشهای مناسب تقسیم میشود.
- بردار هر بخش، همراه متن و مشخصات منبع، در Chroma ذخیره میشود.
- با دریافت سوال کاربر، بخشهای مرتبط بازیابی میشوند.
- برنامه سوال و محتوای بازیابیشده را برای مدل زبانی میفرستد.
- مدل براساس این اطلاعات پاسخ تولید میکند و برنامه میتواند منابع را نیز نمایش دهد.
در این معماری، افزودن اسناد به Chroma به معنی آموزش مجدد مدل زبانی نیست. اطلاعات هنگام پاسخگویی به مدل داده میشوند.
RAG میتواند پاسخگویی بر پایه منابع اختصاصی را ممکن کند، اما خطا را کاملا از بین نمیبرد. اگر سند مرتبط بازیابی نشود یا محتوای قدیمی وارد پاسخ شود، نتیجه همچنان ممکن است نادرست باشد.
Chroma برای چه پروژههایی مناسب است؟
Chroma برای توسعهدهندگانی که میخواهند جستجوی معنایی یا یک سیستم RAG را پیادهسازی کنند، گزینه قابل بررسیای است. امکان شروع محلی و انتقال به معماری سرور، آزمایش ایده را سادهتر میکند.
برای نمونهسازی چتبات، جستجو در مستندات محصول یا ساخت یک ابزار داخلی میتوانید ابتدا با دادههای محدود شروع کنید و کیفیت بازیابی را بسنجید. استفاده در محیط عملیاتی نیز باید با توجه به بار واقعی پروژه ارزیابی شود.
پیش از انتخاب، این موارد را بررسی کنید:
- کیفیت بازیابی: مجموعهای از سوالهای واقعی و سند مورد انتظار هرکدام آماده کنید و ببینید نتیجه درست در میان خروجیها قرار میگیرد یا خیر.
- منابع مورد نیاز: تعداد بردارها، ابعاد آنها، حجم متن و درخواستهای همزمان روی مصرف حافظه و سرعت اثر دارند. در استقرار تکسروری، ظرفیت RAM برای ایندکس برداری اهمیت زیادی دارد.
- سازگاری مدلها: بردار سوال و اسناد باید در یک فضای برداری سازگار تولید شوند. یکسانبودن تعداد ابعاد بهتنهایی کافی نیست؛ تغییر مدل معمولا به تولید دوباره بردارها نیاز دارد.
- نگهداری و دسترسی: نسخهها، پشتیبانگیری، محل ذخیره داده و محدودکردن دسترسی به سرویس باید در طراحی استقرار مشخص باشند.
برای نیازهایی مانند دسترسپذیری بالا یا بار سنگین، قابلیتهای همان نسخه و شیوه استقرار را بررسی کنید. امکانات نسخه متنباز تکسروری را نباید با تمام امکانات Chroma Cloud یکسان فرض کرد.
روشهای اجرای Chroma
روش اجرا را براساس نیاز به ماندگاری داده و نحوه اتصال برنامهها انتخاب کنید.
| روش اجرا | محل نگهداری داده | کاربرد معمول |
|---|---|---|
حافظهای با EphemeralClient | حافظه فرایند | یادگیری و آزمایش موقت |
محلی با PersistentClient | مسیر مشخص روی دیسک | توسعه محلی و استفاده در یک برنامه |
کلاینتـسرور با HttpClient | فضای ذخیره سرویس Chroma | اتصال برنامهها به یک سرویس مشترک |
| Chroma Cloud | زیرساخت مدیریتشده ارائهدهنده | استفاده بدون مدیریت مستقیم سرور Chroma |
در حالت حافظهای، دادهها با پایان فرایند از دست میروند. در حالت محلی پایدار، دادهها روی دیسک ذخیره میشوند و با اجرای دوباره برنامه از همان مسیر قابل استفادهاند. البته در محیط کانتینری، این مسیر باید روی فضای ماندگار قرار بگیرد. مستندات رسمی برای محیط عملیاتی، استفاده از نمونه سروری را توصیه میکند.
حالت سرور زمانی مفید است که چند برنامه یا چند نمونه از یک برنامه به مجموعه مشترکی از دادهها نیاز دارند، یا بخواهید سرویس جستجو را جداگانه مدیریت کنید. این سرویس میتواند روی همان ماشین یا روی زیرساخت دیگری اجرا شود؛ خرید یک سرور جداگانه همیشه ضروری نیست.
Chroma Cloud نیز سرویس مدیریتشده خود Chroma است. انتخاب آن به نیاز پروژه، دسترسی به سرویس و هزینه مصرف بستگی دارد و با میزبانی نسخه متنباز روی یک ارائهدهنده ابری تفاوت دارد.
آموزش شروع کار با Chroma در پایتون
برای یک آزمایش ساده، میتوانید Chroma را بهصورت محلی اجرا کنید. نمونه زیر روی دادههای انگلیسی و با تابع Embedding پیشفرض نوشته شده است.
نصب کتابخانه و ساخت Collection
ابتدا بسته پایتون را نصب کنید:
pip install chromadbسپس یک کلاینت پایدار بسازید و چند متن را به Collection اضافه کنید:
import chromadb

client = chromadb.PersistentClient(path="./chroma_db")
collection = client.get_or_create_collection(name="help_articles")

collection.upsert(
    ids=["account-guide", "python-guide", "billing-guide"],
    documents=[
        "To recover access to your account, use the reset link on the sign-in page.",
        "How to install Python on Ubuntu.",
        "How to change the billing address for your subscription.",
    ],
    metadatas=[
        {"topic": "account"},
        {"topic": "development"},
        {"topic": "billing"},
    ],
)

results = collection.query(
    query_texts=["I forgot my password"],
    n_results=1,
)

print(results["documents"][0])
در این کد، دادهها در پوشه chroma_db ذخیره میشوند. استفاده از upsert نیز اجازه میدهد با اجرای دوباره کد، همان شناسهها بهروزرسانی شوند.
انتظار داریم متن بازیابی دسترسی به حساب، نتیجه مرتبطتری باشد؛ هرچند واژه password در آن وجود ندارد. این نمونه هدف جستجوی معنایی را نشان میدهد و جای ارزیابی روی دادههای واقعی پروژه را نمیگیرد.
تابع پیشفرض پایتون از مدل all-MiniLM-L6-v2 استفاده میکند و ممکن است در اولین اجرا به دانلود فایلهای مدل نیاز داشته باشد.
افزودن فیلتر به جستجو
برای محدودکردن نتایج به موضوع مشخص، از متادیتا استفاده کنید:
results = collection.query(
    query_texts=["How can I update my invoice details?"],
    n_results=1,
    where={"topic": "billing"},
)

print(results["documents"][0])
در این حالت، جستجو به رکوردهای دسته billing محدود میشود.
اجرای Chroma بهصورت سرور
برای جداکردن سرویس Chroma از برنامه، میتوانید سرور محلی را اجرا کنید:
chroma run --path ./chroma_data --host 127.0.0.1 --port 8000سپس در برنامه پایتون به آن متصل شوید:
import chromadb

client = chromadb.HttpClient(host="127.0.0.1", port=8000)
collection = client.get_or_create_collection(name="help_articles")
این مثال برای اتصال محلی است. در استقرار روی شبکه، نشانی، پورت، تنظیمات TLS و احراز هویت باید متناسب با محیط اجرا تنظیم شوند. همچنین تغییر کلاینت، دادههای پوشه محلی قبلی را خودکار به سرویس جدید منتقل نمیکند.
اجرای سرور با تصویر رسمی Docker نیز امکانپذیر است. در این روش باید فضای داده به Volume ماندگار متصل شود تا با جایگزینی کانتینر از بین نرود.
برای جاوااسکریپت و تایپاسکریپت هم بسته chromadb با دستور npm install chromadb نصب میشود. کلاینت آن به سرور Chroma متصل میشود و بسته تابع Embedding مورد نظر نیز ممکن است جداگانه لازم باشد.
راهاندازی Chroma با One-Click App لیارا
اگر میخواهید Chroma را بهصورت یک سرویس مستقل در اختیار برنامه قرار دهید، باید محیط اجرا، فضای داده و تنظیمات اتصال آن را آماده کنید. لیارا Chroma را در بخش برنامههای آماده یا One-Click App ارائه میدهد تا مراحل نصب اولیه سادهتر شود.
براساس مستندات برنامه آماده لیارا، روند راهاندازی به این صورت است:
- وارد کنسول لیارا شوید و حساب شخصی یا تیم مورد نظر را انتخاب کنید.
- از بخش “برنامههای آماده”، برنامه Chroma را باز کنید.
- روش نصب سریع یا پیشرفته را انتخاب کرده و مشخصات مورد نیاز را وارد کنید.
- پس از نصب، وضعیت برنامه را از بخش رویدادها و لاگها بررسی کنید.
- برنامه خود را با اطلاعات اتصال و احراز هویت نمونه ایجادشده پیکربندی کنید.
جمع بندی
Chroma ابزار ذخیره و بازیابی بردارهاست که میتوان از آن برای جستجوی معنایی، چتبات روی مستندات و سیستمهای RAG استفاده کرد. امکان شروع محلی، مدیریت متادیتا و اتصال به ابزارهای توسعه هوش مصنوعی، آن را به گزینهای قابل بررسی برای این پروژهها تبدیل میکند.
برای انتخاب درست، ابتدا کیفیت بازیابی را با دادههای واقعی بسنجید و سپس روش اجرا و منابع را مشخص کنید. اگر به یک سرویس مستقل نیاز دارید، برنامه آماده Chroma در لیارا مسیر نصب اولیه و مدیریت محیط اجرا را سادهتر میکند.
سوالات متداول
آیا Chroma رایگان است؟
نسخه متنباز Chroma با مجوز Apache 2.0 ارائه میشود و برای استفاده از خود نرمافزار هزینه لایسنس پرداخت نمیکنید. هزینه زیرساخت، نگهداری و در صورت استفاده، API تولید Embedding یا مدل زبانی جداست. سرویسهای میزبانی و Chroma Cloud نیز تعرفه خود را دارند.
آیا Chroma از زبان فارسی پشتیبانی می کند؟
میتوانید متن فارسی را در Chroma ذخیره کنید، اما کیفیت جستجوی معنایی به مدل Embedding بستگی دارد. مدلی انتخاب کنید که فارسی را پشتیبانی کند و آن را با سوالها و متنهای واقعی خود، از جمله عبارتهای محاورهای و تفاوتهای نگارشی، بسنجید.
آیا برای استفاده از Chroma به سرور جداگانه نیاز داریم؟
خیر. در پایتون میتوانید از حالت حافظهای یا ذخیره محلی استفاده کنید. اجرای سرور برای اتصال چند برنامه یا مدیریت مستقل سرویس مفید است و حتی آن هم میتواند روی ماشین فعلی شما انجام شود.
آیا Chroma جایگزین PostgreSQL یا MySQL است؟
برای مدیریت سفارشها، پرداختها و دادههای تراکنشی، معمولا همچنان به دیتابیس عملیاتی نیاز دارید. Chroma میتواند لایه بازیابی معنایی برنامه باشد. در PostgreSQL، استفاده از pgvector نیز راه دیگری برای افزودن جستجوی برداری است.
آیا Chroma خودش فایل PDF را به چت بات تبدیل می کند؟
خیر. استخراج متن، تقسیمبندی، تولید بردار، بازیابی و تولید پاسخ مراحل جداگانهاند. Chroma بخش ذخیرهسازی و بازیابی را پوشش میدهد و برای ساخت چتبات باید این مراحل در برنامه به هم متصل شوند.
آیا Chroma به GPU نیاز دارد؟
برای شروع کار با Chroma و اجرای نمونه بالا، GPU الزامی نیست. نیاز به GPU بیشتر به مدل و روش تولید Embedding وابسته است. اگر از API بیرونی استفاده کنید، پردازش مدل روی زیرساخت ارائهدهنده انجام میشود.
داده های Chroma بعد از ریاستارت باقی می مانند؟
در حالت حافظهای خیر. با PersistentClient یا سروری که مسیر داده آن روی فضای ماندگار تنظیم شده باشد، دادهها قابل نگهداریاند. ماندگاری دیسک جای پشتیبانگیری را نمیگیرد.