آنچه در این مقاله میخوانید
SGLang چیست؟ معرفی فریم ورک اجرای LLMها و کاربردهای آن
 هنگامه رحیمی
۲۹ مهر ۱۴۰۵
خلاصه کنید:
اجرای مدلهای زبانی بزرگ (LLM) در محیطهای عملیاتی، تنها به قدرت پردازشی GPU وابسته نیست. زمانی که یک چتبات یا عامل هوش مصنوعی باید همزمان به چندین درخواست پاسخ دهد، مدیریت حافظه، کاهش تأخیر و جلوگیری از محاسبات تکراری به چالشهای مهمی تبدیل میشوند. این مشکلات در برنامههایی که برای انجام یک وظیفه چندین بار مدل را فراخوانی میکنند، بیشتر به چشم میآیند.
SGLang یکی از فریمورکهایی است که برای بهینهسازی اجرای مدلهای هوش مصنوعی توسعه یافته است. این فریمورک با استفاده از فناوریهایی مانند RadixAttention و Continuous Batching، پردازش درخواستها و استفاده از حافظه GPU را بهینه میکند. در این مقاله، معماری و نحوه عملکرد SGLang، قابلیتها، کاربردها و تفاوت آن با فریمورکهایی مانند vLLM را بررسی میکنیم و به مراحل اولیه راهاندازی آن میپردازیم.
SGLang چیست؟
SGLang مخفف Structured Generation Language، یک فریمورک متنباز برای اجرای سریع و بهینه مدلهای زبانی بزرگ (LLM) است. این فریمورک توسط پژوهشگران LMSYS، گروه توسعهدهنده Chatbot Arena، معرفی شد و هدف آن کاهش تأخیر در پاسخگویی مدلها، مدیریت درخواستهای همزمان و بهینهسازی اجرای وظایف چندمرحلهای است.
SGLang برخلاف مدلهایی مانند Llama , DeepSeek و Qwen، خودش یک مدل هوش مصنوعی نیست؛ بلکه یک فریمورک سروینگ مدل (Model Serving Framework) است که اجرای مدلهای زبانی را مدیریت میکند. به عبارت دیگر، مدل وظیفه تولید پاسخ را برعهده دارد و SGLang با مدیریت درخواستها، حافظه و منابع محاسباتی مانند GPU، تلاش میکند سرعت پاسخگویی و توان عملیاتی مدل را افزایش دهد.
معماری SGLang از دو بخش اصلی تشکیل شده است: یک لایه برنامهنویسی مبتنی بر پایتون برای تعریف جریان تولید متن و تعاملات چندمرحلهای با مدل، و یک محیط اجرایی (Runtime) برای مدیریت فرآیند استنتاج هوش مصنوعی (AI Inference)، یعنی پردازش ورودیهای جدید و تولید پاسخ توسط مدل آموزشدیده. این دو بخش به توسعهدهندگان کمک میکنند برنامههایی مانند چتباتها، سیستمهای RAG و عاملهای هوش مصنوعی (AI Agents) را با محاسبات تکراری کمتر و استفاده بهینهتر از منابع GPU اجرا کنند.
SGLang چگونه کار می کند؟
SGLang با جدا کردن منطق برنامه از اجرای مدل زبانی، پردازش درخواستها را مدیریت میکند. وظایفی مانند زمانبندی درخواستها، مدیریت حافظه و استفاده مجدد از محاسبات قبلی در محیط اجرایی (Runtime) انجام میشوند. این روش به کاهش پردازشهای تکراری و استفاده بهتر از منابع GPU کمک میکند.
معماری SGLang چگونه است؟ بررسی Frontend و Runtime
معماری SGLang از دو بخش اصلی تشکیل شده است. Frontend یک رابط برنامهنویسی مبتنی بر پایتون است که توسعهدهندگان با استفاده از آن میتوانند ترتیب اجرای وظایف، فراخوانیهای متوالی مدل و نحوه تولید خروجیهای ساختاریافته را مشخص کنند.
بخش دوم، Runtime، مسئول اجرای مدل و مدیریت منابع محاسباتی است. این بخش با زمانبندی درخواستها، مدیریت KV Cache و پردازش دستهای، تلاش میکند زمان انتظار را کاهش دهد و از ظرفیت GPU برای پاسخگویی به درخواستهای بیشتر استفاده کند.
RadixAttention چیست و چگونه عملکرد SGLang را بهبود می دهد؟
RadixAttention یکی از قابلیتهای اصلی SGLang برای کاهش محاسبات تکراری است. این مکانیزم، دادههای KV Cache مربوط به توکنهای پردازششده را با استفاده از ساختار Radix Tree سازماندهی میکند تا درخواستهایی که پیشوند یکسانی دارند، بتوانند از محاسبات ذخیرهشده استفاده کنند.
برای مثال، فرض کنید یک چتبات پشتیبانی روزانه به ۱۰۰۰ درخواست با System Prompt یکسان پاسخ میدهد. SGLang میتواند محاسبات مربوط به این بخش مشترک را در حافظه نگه دارد و هنگام دریافت درخواستهای بعدی، فقط توکنهای جدید را پردازش کند. البته این قابلیت زمانی مؤثر است که دادههای موردنیاز همچنان در Cache موجود باشند.
Continuous Batching چیست و چه نقشی در پردازش درخواست ها دارد؟
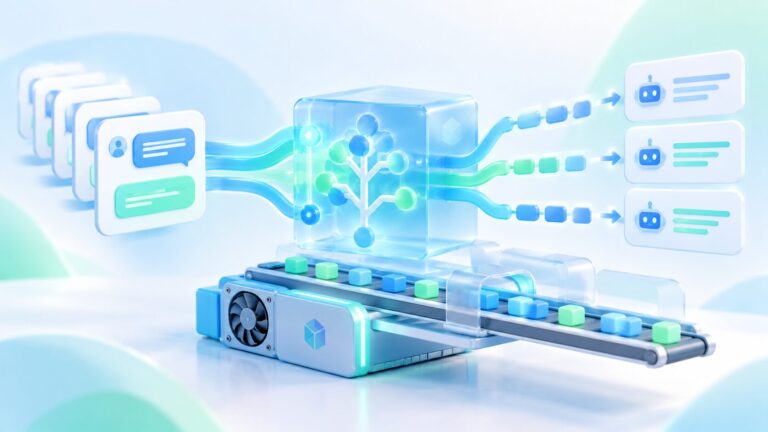
در پردازش دستهای سنتی (Static Batching)، درخواستها در گروههای ثابت اجرا میشوند. در این روش، کوتاهتر بودن بعضی درخواستها ممکن است باعث شود بخشی از ظرفیت پردازشی تا پایان اجرای سایر درخواستها بدون استفاده بماند.
Continuous Batching با زمانبندی پویای درخواستها این مشکل را کاهش میدهد. با تکمیل هر درخواست، منابع آن آزاد میشوند و درخواستهای جدید میتوانند در مراحل بعدی پردازش وارد Batch شوند. به این ترتیب، GPU زمان کمتری را بدون پردازش سپری میکند و توان عملیاتی (Throughput) سرویس، بهویژه هنگام دریافت درخواستهای همزمان، افزایش مییابد.
مهم ترین قابلیت های SGLang چیست؟
SGLang علاوه بر افزایش سرعت استنتاج مدلهای زبانی، قابلیتهایی برای مدیریت خروجی، کاهش مصرف حافظه GPU و اتصال مدلها به برنامههای مختلف دارد. در ادامه، مهمترین ویژگیهای این فریمورک را بررسی میکنیم.
تولید خروجی ساختاریافته با JSON و Regex
SGLang امکان تولید خروجی در قالبهای مشخص مانند JSON و الگوهای Regex را فراهم میکند. برای مثال، هنگام استخراج اطلاعات از اسناد، میتوان ساختار خروجی را تعیین کرد تا مدل دادهها را در قالب JSON برگرداند. به این ترتیب، استفاده از اطلاعات در بکاند یا ذخیره آنها در دیتابیس به پردازش متنی کمتری نیاز خواهد داشت.
کاهش مصرف حافظه GPU با Quantization
SGLang از روشهای کوانتیزاسیون (Quantization) مانند FP8، INT4، AWQ و GPTQ پشتیبانی میکند. این روشها با کاهش دقت عددی پارامترهای مدل، مصرف حافظه را کمتر میکنند و اجرای مدلهای بزرگتر را روی GPUهایی با حافظه محدودتر امکانپذیر میسازند. میزان کاهش مصرف حافظه و تأثیر آن بر کیفیت پاسخها به روش کوانتیزاسیون و مدل انتخابشده بستگی دارد.
افزایش سرعت تولید پاسخ با Speculative Decoding
قابلیت Speculative Decoding با پیشبینی و بررسی همزمان چند توکن، زمان تولید پاسخ را کاهش میدهد. در یکی از روشهای رایج، یک مدل کوچکتر توکنهای بعدی را پیشنهاد میدهد و مدل اصلی آنها را بررسی میکند. در صورت تأیید چند توکن، مدل میتواند با مراحل پردازشی متوالی کمتری پاسخ را تولید کند.
اتصال به برنامه ها با API سازگار با OpenAI
SGLang API سازگار با OpenAI ارائه میدهد که اتصال آن به برنامههای موجود را سادهتر میکند. در بسیاری از برنامههایی که از OpenAI SDK استفاده میکنند، میتوان با تغییر آدرس Endpoint و نام مدل، درخواستها را به سرور SGLang فرستاد؛ بدون اینکه نیازی به بازنویسی کامل کدهای ارتباط با مدل باشد.
پشتیبانی از مدل های زبانی و سخت افزارهای مختلف
SGLang از خانواده مدلهایی مانند Llama، Qwen و DeepSeek، برخی مدلهای چندوجهی و مدلهای Diffusion پشتیبانی میکند. این فریمورک همچنین قابلیت اجرا روی GPUهای NVIDIA و AMD و برخی شتابدهندههای دیگر را دارد. بااینحال، پشتیبانی از مدلها و قابلیتهایی مانند Quantization یا Speculative Decoding ممکن است بسته به سختافزار و نسخه SGLang متفاوت باشد.
کاربردهای SGLang چیست؟
SGLang برای اجرای برنامههایی کاربرد دارد که به فراخوانی مکرر مدلهای زبانی یا پردازش همزمان تعداد زیادی درخواست نیاز دارند. این فریمورک با مدیریت حافظه و بهینهسازی پردازش روی GPU، اجرای عاملهای هوش مصنوعی، چتباتها و سرویسهای مبتنی بر LLM را بهبود میدهد.
اجرای عامل های هوش مصنوعی (AI Agents)
عاملهای هوش مصنوعی برای انجام کارهایی مانند جستوجوی اطلاعات، تحلیل داده و تصمیمگیری، معمولاً چندین بار مدل زبانی را فراخوانی میکنند. SGLang با استفاده مجدد از بخشهای مشترک پرامپت (Prompt)، محاسبات تکراری را کاهش میدهد و اجرای وظایف چندمرحلهای را سریعتر میکند.
ساخت چت بات و دستیار هوشمند
در چتباتهایی با مکالمات طولانی یا تعداد کاربران بالا، پردازش مکرر تاریخچه گفتگو میتواند منابع زیادی مصرف کند. SGLang با مدیریت KV Cache و استفاده مجدد از محاسبات ذخیرهشده، پردازش درخواستهای بعدی را بهینه میکند.
پیاده سازی سیستم های RAG
در سیستمهای تولید مبتنی بر بازیابی اطلاعات (RAG)، اطلاعات بازیابیشده از منابعی مانند دیتابیس برداری، همراه با پرسش کاربر به مدل ارسال میشوند. SGLang با ذخیره و استفاده مجدد از بخشهای مشترک پرامپت و محتوای تکراری، میتواند زمان پردازش درخواستها را کاهش دهد.
تولید خروجی JSON و داده های ساختاریافته
در کاربردهایی مانند استخراج اطلاعات از اسناد، دستهبندی تیکتها و پردازش خودکار دادهها، خروجی مدل باید ساختار مشخصی داشته باشد. SGLang امکان محدود کردن خروجی به قالبهایی مانند JSON را فراهم میکند تا پردازش اطلاعات در بکاند و ذخیره آنها در دیتابیس سادهتر شود.
پردازش هم زمان درخواست های مدل زبانی (LLM Serving)
در سرویسهایی که از طریق API به تعداد زیادی کاربر پاسخ میدهند، مدیریت درخواستهای همزمان اهمیت زیادی دارد. SGLang با استفاده از قابلیت Continuous Batching، درخواستها را بهصورت پویا دستهبندی و پردازش میکند تا از ظرفیت GPU بهتر استفاده شود.
اجرای مدل های چندوجهی (Multimodal)
SGLang علاوه بر مدلهای زبانی متنی، از برخی مدلهای چندوجهی برای پردازش همزمان متن و تصویر پشتیبانی میکند. همچنین امکان اجرای برخی مدلهای Diffusion برای تولید تصویر و ویدئو را فراهم میکند؛ البته میزان پشتیبانی به مدل و نسخه SGLang بستگی دارد.
تفاوت SGLang با vLLM و TensorRT-LLM چیست؟
فریمورکهای SGLang , vLLM و TensorRT-LLM هر سه برای اجرای بهینه مدلهای زبانی بزرگ (LLM) طراحی شدهاند، اما در مدیریت حافظه، سازگاری با سختافزار و شیوه پردازش درخواستها تفاوت دارند.
SGLang با فناوری RadixAttention بر استفاده مجدد از بخشهای مشترک Prompt تمرکز دارد و برای برنامههای چندمرحلهای و عاملهای هوش مصنوعی مناسب است. در مقابل، vLLM با فناوری PagedAttention حافظه KV Cache را بهصورت بلوکی مدیریت میکند و گزینهای برای سروینگ عمومی مدلهای زبانی است. البته vLLM نیز از Prefix Caching پشتیبانی میکند.
TensorRT-LLM توسط NVIDIA توسعه یافته و با استفاده از کرنلهای بهینهشده، بهبود عملکرد استنتاج روی GPUهای این شرکت را دنبال میکند.
جدول زیر تفاوتهای اصلی این سه فریمورک را نشان میدهد:
| معیار | SGLang | vLLM | TensorRT-LLM |
|---|---|---|---|
| تمرکز اصلی | پردازش چندمرحلهای و سروینگ LLM | سروینگ عمومی با توان عملیاتی بالا | بهینهسازی استنتاج روی NVIDIA |
| مدیریت KV Cache | RadixAttention | PagedAttention و Prefix Caching | Paged KV Cache و Cache Reuse |
| خروجی ساختاریافته | پشتیبانی از JSON و Regex | پشتیبانی از خروجی ساختاریافته | وابسته به API و پیکربندی |
| سختافزار | NVIDIA و AMD | NVIDIA، AMD و برخی CPUها | GPUهای NVIDIA |
| راهاندازی | نیازمند تنظیمات متناسب با مدل | راهاندازی نسبتاً ساده | نیازمند تنظیمات تخصصیتر |
| کاربرد مناسب | AI Agent , RAG و Promptهای تکراری | چتبات و APIهای عمومی | سروینگ بهینه روی زیرساخت NVIDIA |
انتخاب میان این ابزارها به نوع مدل، سختافزار و الگوی درخواستها بستگی دارد. برای مثال، SGLang در پردازش Promptهای مشترک میتواند محاسبات تکراری را کاهش دهد، اما این موضوع به معنای سریعتر بودن آن نسبت به vLLM در تمام شرایط نیست. برای مقایسه دقیق عملکرد، باید معیارهایی مانند Latency , Throughput , نرخ Cache Hit و تعداد درخواستهای همزمان را روی زیرساخت یکسان بررسی کرد.
مزایا و محدودیت های SGLang
SGLang با هدف بهینهسازی استنتاج مدلهای زبانی توسعه یافته است، اما میزان کارایی آن به نوع مدل، سختافزار و الگوی درخواستها بستگی دارد. پیش از انتخاب این فریمورک برای محیط عملیاتی (Production)، بهتر است مزایا و محدودیتهای آن را بررسی کنید.
مزایای SGLang
- کاهش محاسبات تکراری: فناوری RadixAttention با استفاده مجدد از KV Cache، پردازش بخشهای مشترک Promptها را کاهش میدهد.
- افزایش توان عملیاتی: Continuous Batching امکان پردازش پویای درخواستهای همزمان و استفاده بهینهتر از GPU را فراهم میکند.
- تولید خروجی ساختاریافته: پشتیبانی از JSON و Regex، پردازش پاسخهای مدل در برنامههای Backend را سادهتر میکند.
- سازگاری با APIهای OpenAI: اتصال برنامههای موجود به سرور SGLang را با تغییرات محدود امکانپذیر میسازد.
- مناسب برای AI Agentها: اجرای جریانهای چندمرحلهای و درخواستهای وابسته به یکدیگر را بهینه میکند.
محدودیت های SGLang
- پیچیدگی راهاندازی: استقرار در محیط Production به تنظیماتی مانند مدیریت حافظه، زمانبندی درخواستها و مانیتورینگ نیاز دارد.
- وابستگی به منابع سختافزاری: اجرای مدلهای بزرگ به GPU مناسب و حافظه کافی نیاز دارد.
- نیاز به دانش فنی: پیکربندی آن نسبت به اجرای مستقیم مدل با کتابخانه Transformers پیچیدهتر است.
- وابستگی عملکرد Cache به الگوی درخواستها: در درخواستهایی با Promptهای کاملاً متفاوت، فرصت استفاده مجدد از Cache کاهش مییابد.
نصب و راه اندازی SGLang چگونه است؟
برای اجرای SGLang میتوان از Docker یا نصب مستقیم با Python استفاده کرد. در این بخش، روش نصب با ابزار uv و راهاندازی یک مدل زبانی بهعنوان سرویس API را بررسی میکنیم.
پیش نیازهای اجرای SGLang
پیش از نصب، به سیستمعامل لینوکس، Python نسخه 3.11 یا بالاتر و GPU سازگار با حافظه کافی نیاز دارید. در محیط NVIDIA، نسخههای جدید SGLang به درایور سازگار با CUDA 13 نیاز دارند. همچنین باید فضای ذخیرهسازی کافی برای دانلود وزنهای مدل در نظر بگیرید.
نصب SGLang با uv
ابتدا ابزار uv را نصب کرده و یک محیط مجازی ایجاد کنید:
pip install uv
uv venv --python 3.12
source .venv/bin/activate
سپس SGLang را با دستور زیر نصب کنید:
uv pip install --prerelease=allow sglangاجرای یک مدل و ساخت API
پس از نصب، میتوانید مدل موردنظر را از Hugging Face بارگذاری و سرور استنتاج را اجرا کنید:
python -m sglang.launch_server \
  --model-path Qwen/Qwen2.5-3B-Instruct \
  --host 127.0.0.1 \
  --port 30000
پس از بارگذاری مدل، API محلی روی پورت 30000 در دسترس قرار میگیرد و میتوانید درخواستهای خود را از طریق Endpointهای سازگار با OpenAI ارسال کنید. برای استفاده در محیط Production، تنظیمات امنیتی، منابع GPU و دسترسی شبکه باید جداگانه بررسی شوند.
چه زمانی از SGLang استفاده کنیم؟
انتخاب SGLang به حجم درخواستها، ساختار برنامه و میزان کنترلی که بر اجرای مدل نیاز دارید بستگی دارد. این فریمورک زمانی ارزش بیشتری دارد که بهینهسازی مصرف منابع و سرعت پاسخگویی، بخشی از نیازهای اصلی پروژه باشد.
SGLang انتخاب مناسبی است اگر:
- برنامه شما از AI Agentهای چندمرحلهای استفاده میکند که مدل را چندین بار فراخوانی میکنند.
- درخواستها دارای Promptهای مشترک هستند و استفاده مجدد از KV Cache میتواند محاسبات تکراری را کاهش دهد.
- به خروجیهای ساختاریافته مانند JSON برای پردازش مستقیم در Backend نیاز دارید.
- سرویس شما تعداد زیادی درخواست همزمان دریافت میکند و افزایش توان عملیاتی اهمیت دارد.
- قصد دارید مدلهای زبانی را روی زیرساخت اختصاصی خود اجرا و مدیریت کنید.
چه زمانی SGLang انتخاب مناسبی نیست؟
اگر برنامه شما روزانه تعداد محدودی درخواست ساده پردازش میکند، استفاده از API آماده ارائهدهندگان مدل ممکن است مقرونبهصرفهتر باشد. همچنین، اگر منابع GPU کافی یا تخصص لازم برای مدیریت زیرساخت استنتاج را ندارید، راهاندازی SGLang میتواند پیچیدگی و هزینه عملیاتی غیرضروری ایجاد کند.
راه اندازی و استفاده از SGLang در لیارا
برای استفاده از SGLang در پروژههای هوش مصنوعی، نیازی نیست بکاند برنامه و سرور استنتاج مدل (Inference Server) روی یک سرور اجرا شوند. میتوان این دو بخش را جداگانه مستقر کرد تا منابع هرکدام متناسب با نیازشان انتخاب و مدیریت شود. در این معماری، سرویسهای ابری لیارا میتوانند میزبانی بکاند، API و بخشهای مرتبط با دیتابیس را برعهده بگیرند.
اجرای بک اند برنامه با سرور مجازی ابری لیارا
سرور مجازی ابری لیارا امکان راهاندازی محیط لینوکسی برای اجرای بکاند و مدیریت API را فراهم میکند. توسعهدهندگان میتوانند منطق برنامه، مدیریت درخواستهای کاربران و ارتباط با سرور استنتاج SGLang را روی این سرورها پیادهسازی کنند.
برای اجرای مستقیم مدلهای زبانی بزرگ با SGLang، معمولاً به GPU سازگار و حافظه گرافیکی (VRAM) کافی نیاز است. بنابراین، باید منابع سختافزاری موردنیاز مدل را جداگانه بررسی کرد و از سازگاری سرور استنتاج با آن مطمئن شد.
اتصال هاست پایتون لیارا به سرور SGLang
اگر SGLang روی سروری مجهز به GPU اجرا میشود، میتوان بکاند پایتونی برنامه را روی هاست ابری پایتون لیارا مستقر کرد.
در این روش، برنامه پایتونی درخواستها را از طریق API به سرور SGLang ارسال میکند و پاسخ مدل را دریافت میکند. پردازش مدل روی سرور GPU انجام میشود، درحالیکه مدیریت کاربران، منطق برنامه و ارتباط با دیتابیس برعهده بکاند مستقر در لیارا است.
این معماری برای توسعه چتباتها، سیستمهای RAG و عاملهای هوش مصنوعی کاربرد دارد و امکان مدیریت و مقیاسدهی مستقل بکاند و سرور استنتاج را فراهم میکند.
برای آشنایی با پیشنیازهای سختافزاری، روش نصب و پیکربندی سرور استنتاج، به مستندات رسمی SGLang مراجعه کنید.
جمع بندی
SGLang یک فریمورک متنباز برای اجرای سریع و مقیاسپذیر مدلهای زبانی بزرگ و مدلهای چندوجهی است که بهطور ویژه برای سروینگ LLM، برنامههای چندمرحلهای و AI Agentها طراحی شده است. فناوریهایی مانند RadixAttention، پردازش دستهای پیوسته (Continuous Batching)، خروجیهای ساختاریافته و Quantization به SGLang کمک میکنند تا استفاده بهینهتری از منابع محاسباتی داشته باشد و درخواستهای همزمان را با کارایی بیشتری پردازش کند.
بااینحال، انتخاب SGLang باید براساس نوع پروژه انجام شود. اگر برنامه شما شامل Promptهای تکراری، Agentهای چندمرحلهای، RAG یا تعداد زیادی درخواست همزمان است، قابلیتهایی مانند RadixAttention میتوانند مزیت قابلتوجهی ایجاد کنند. در مقابل، برای پروژههای کوچک با تعداد درخواست محدود، استفاده از چنین Runtime پیشرفتهای ممکن است پیچیدگی غیرضروری به زیرساخت اضافه کند.
سوالات متداول
SGLang چیست و چه کاربردی دارد؟
SGLang یک فریمورک متنباز برای اجرای بهینه مدلهای زبانی بزرگ (LLM) است. این فریمورک با مدیریت درخواستهای همزمان، حافظه GPU و خروجیهای ساختاریافته، برای توسعه چتباتها، سیستمهای RAG و عاملهای هوش مصنوعی استفاده میشود.
RadixAttention در SGLang چیست؟
RadixAttention مکانیزمی برای استفاده مجدد از KV Cache در درخواستهایی با پیشوند مشترک است. این قابلیت با ذخیره محاسبات قبلی در ساختار Radix Tree، پردازش تکراری بخشهایی مانند System Prompt یکسان را کاهش میدهد و میتواند سرعت پاسخگویی مدل را افزایش دهد.
آیا SGLang از vLLM سریع تر است؟
نمیتوان SGLang را در تمام شرایط سریعتر از vLLM دانست. هر دو فریمورک از بهینهسازیهایی مانند Prefix Caching و Continuous Batching پشتیبانی میکنند. عملکرد آنها به مدل، سختافزار، تعداد درخواستهای همزمان و میزان اشتراک پرامپتها بستگی دارد.
آیا SGLang با APIهای OpenAI سازگار است؟
بله. SGLang رابط API سازگار با OpenAI ارائه میدهد. در بسیاری از برنامههایی که از OpenAI SDK استفاده میکنند، میتوان با تغییر Base URL و نام مدل، درخواستها را به سرور SGLang ارسال کرد.
SGLang از چه مدل هایی پشتیبانی می کند؟
SGLang از خانواده مدلهایی مانند Llama، Qwen و DeepSeek و همچنین برخی مدلهای چندوجهی، Embedding، Reranking و Diffusion پشتیبانی میکند. سازگاری هر مدل به نسخه SGLang و سختافزار مورد استفاده بستگی دارد.
آیا برای اجرای SGLang به GPU نیاز داریم؟
برای اجرای عملی مدلهای زبانی بزرگ با SGLang معمولاً به GPU سازگار و حافظه گرافیکی (VRAM) کافی نیاز است. مقدار VRAM موردنیاز به اندازه مدل، روش Quantization و تعداد درخواستهای همزمان بستگی دارد.