آنچه در این مقاله میخوانید
- رصدپذیری مدل زبانی چیست و چه تفاوتی با مانیتورینگ سنتی دارد؟
- مهم ترین معیارهای ارزیابی کارایی مدل های زبانی کدامند؟
- مزایای پیاده سازی رصدپذیری در چرخه حیات ایجنت های هوش مصنوعی
- استاندارد اوپن تلمتری و نقش آن در ردگیری جریان داده های هوش مصنوعی
- معیارهای انتخاب ابزار رصدپذیری متناسب با زیرساخت سازمان
- برترین ابزارهای متن باز رصدپذیری مدل زبانی و ایجنت هوش مصنوعی
- برترین پلتفرم های ابری و تجاری رصدپذیری مدل زبانی
- برترین پلتفرم های جامع سازمانی با قابلیت مانیتورینگ هوش مصنوعی
- جدول مقایسه جامع ابزارهای رصدپذیری مدل زبانی و ایجنت های هوش مصنوعی
- پیاده سازی رصدپذیری و زیرساخت ایجنت های هوش مصنوعی در سرورهای ابری لیارا
- جمع بندی
- سوالات متداول
ابزارهای مشاهده پذیری LLM | رصدپذیری سریع ایجنت های هوش مصنوعی
 المیرا سادات اسدی
۱۷ آبان ۱۴۰۵
خلاصه کنید:


مدلهای زبانی بزرگ (LLMs) و ایجنتهای هوش مصنوعی به سرعت در حال تبدیل شدن به قلب تپنده بسیاری از اپلیکیشنهای نوآورانه هستند. اما با افزایش پیچیدگی و قابلیتهای این سیستمها، درک نحوه عملکرد آنها و اطمینان از صحت خروجیها چالشبرانگیزتر میشود. اینجاست که ابزارهای مشاهده پذیری LLM به کار میآیند.
برای درک ساده مفاهیم LLM و نحوه کار مدلهای زبانی بزرگ، با مقاله زیر شروع کنید. مدل زبانی بزرگ (LLM) چیست؟
درک عمیق عملکرد درونی مدلهای هوش مصنوعی، که رصدپذیری (Observability) نام دارد، برای موفقیت پروژههای هوش مصنوعی حیاتی است. ابزارهای مشاهده پذیری LLM دقیقاً برای رسیدن به همین درک ساخته شدهاند.
برخلاف مانیتورینگ سنتی که عمدتاً بر معیارهای زیرساختی مانند آپتایم و مصرف منابع تمرکز دارد، رصدپذیری مدل زبانی کار دیگری میکند. این رویکرد به شما امکان میدهد رفتار مدل، کیفیت خروجیها و دلایل پشت هر نتیجه را تحلیل کنید.
این مقاله به بررسی ابزارهای کلیدی میپردازد که به شما کمک میکنند تا مدلهای زبانی و ایجنتهای هوش مصنوعی خود را به طور مؤثر رصد و مدیریت کنید.
رصدپذیری مدل زبانی چیست و چه تفاوتی با مانیتورینگ سنتی دارد؟
رصدپذیری مدل زبانی (LLM Observability) یعنی توانایی درک و تحلیل عملکرد درونی مدلهای هوش مصنوعی. این کار به شما کمک میکند بفهمید مدل دقیقاً چه کاری انجام میدهد، چرا نتایج خاصی تولید میکند و چطور میتوان آن را بهبود داد.
مانیتورینگ سنتی معمولاً روی معیارهای بیرونی مثل آپتایم سرور، مصرف منابع (CPU، رم) و سرعت پاسخدهی تمرکز دارد. این معیارها برای اپلیکیشنهای کلاسیک مهم هستند، اما برای مدلهای زبانی کافی نیستند.
مدلهای زبانی پیچیدگیهای بیشتری دارند. مثلاً کیفیت خروجی، میزان توهم (Hallucination) یا حتی رفتار مدل در مواجهه با ورودیهای مختلف، معیارهای مهمی هستند که در مانیتورینگ سنتی جایی ندارند.
رصدپذیری به شما اجازه میدهد این لایههای عمیقتر را ببینید. شما میتوانید جریان کامل درخواست کاربر، نحوه پردازش آن توسط مدل، استفاده از ابزارهای خارجی (مثل جستجو در وب) و در نهایت خروجی نهایی را ردیابی کنید.
عامل هوش مصنوعی چیست؟ هر آنچه باید در مورد آن ها بدانید
عامل هوش مصنوعی چیست؟
مقایسه رصدپذیری هوش مصنوعی با مانیتورینگ نرم افزار و MLOps
مانیتورینگ نرمافزار (Software Monitoring) معمولاً به سلامت و عملکرد سیستمهای IT میپردازد. تمرکز اصلی روی در دسترس بودن سرویسها، زمان پاسخدهی و خطاهای فنی است.
MLOps (Machine Learning Operations) رویکردی است که چرخه حیات مدلهای یادگیری ماشین را مدیریت میکند. این شامل جمعآوری داده، آموزش مدل، دیپلوی و مانیتورینگ عملکرد مدل در محیط عملیاتی است.
رصدپذیری هوش مصنوعی (AI Observability) فراتر از این دو میرود. در حالی که MLOps به جنبههای عملیاتی مدلهای ML میپردازد، رصدپذیری روی درک عمیقتر رفتار مدلهای هوش مصنوعی، بهخصوص مدلهای زبانی بزرگ (LLMs) و ایجنتها، تمرکز دارد.
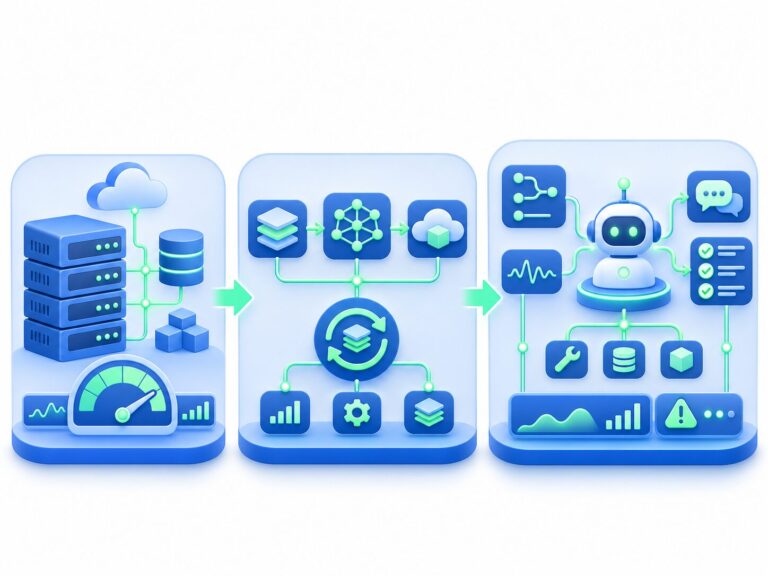
در واقع، رصدپذیری هوش مصنوعی لایهای جدید برای فهمیدن “چرا” پشت نتایج مدل اضافه میکند و این لایه شامل موارد زیر است:
- ردیابی توکنها
- ارزیابی کیفیت پاسخها
- شناسایی و کاهش توهمات
- تحلیل تعاملات پیچیده ایجنتها با ابزارهای مختلف
- مانیتورینگ نرمافزار: تمرکز بر سلامت زیرساخت و سرویس.
- MLOps: مدیریت چرخه عمر مدلهای ML، شامل دیپلوی و عملکرد.
- رصدپذیری هوش مصنوعی: درک عمیق رفتار مدلهای هوش مصنوعی، بهویژه LLMها و ایجنتها، و تحلیل دلایل خروجیها.
این رویکرد جدید به شما کمک میکند تا مدلهای هوش مصنوعی خود را بهتر کنترل کنید و از عملکرد قابل اعتماد و قابل پیشبینی آنها اطمینان حاصل کنید.
مهم ترین معیارهای ارزیابی کارایی مدل های زبانی کدامند؟
ارزیابی کارایی مدلهای زبانی فقط به دقت خروجی خلاصه نمیشود. شما باید جنبههای مختلفی را بسنجید تا مطمئن شوید مدل در دنیای واقعی و در شرایط مختلف، عملکرد خوبی دارد. این معیارها به شما کمک میکنند تا نقاط قوت و ضعف مدل را بشناسید و آن را بهینه کنید.
این ارزیابی برای ساخت ایجنتهای هوش مصنوعی که نیاز به پاسخدهی سریع و پایدار دارند، حیاتی است.
درک این معیارها به شما کمک میکند تا ابزار مناسب را انتخاب کنید و زیرساخت لازم را فراهم آورید. این کار باعث میشود تا تجربه کاربری بهتری داشته باشید و هزینههای عملیاتی را مدیریت کنید.
معیارهای تاخیر شامل زمان تا اولین توکن و سرعت تولید پاسخ
یکی از مهمترین معیارهای عملکرد، سرعت پاسخدهی مدل است. این موضوع در تجربه کاربری تأثیر مستقیم دارد، چون هیچکس دوست ندارد منتظر پاسخ بماند.
دو معیار اصلی در اینجا وجود دارد: زمان تا اولین توکن (Time To First Token یا TTFT) و سرعت کلی تولید پاسخ (Tokens Per Second یا TPS). TTFT مدت زمانی است که طول میکشد تا مدل اولین بخش از پاسخ را تولید کند.
TPS نشان میدهد مدل با چه سرعتی توکنهای بعدی را تولید میکند.
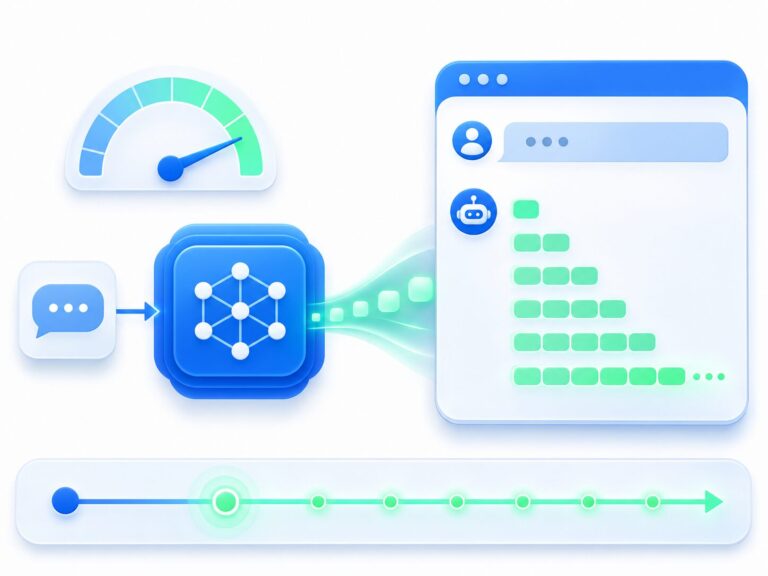
برای مثال، در یک چتبات، TTFT پایین باعث میشود کاربر حس کند مکالمه روان است. TPS بالا هم باعث میشود پاسخ کامل سریعتر ارائه شود. اگر این معیارها در حد انتظار نباشند، ممکن است کاربر تصور کند سیستم کند یا خراب است.
در سیستمهای تعاملی مثل چتباتها، TTFT اهمیت بیشتری دارد چون حس اولیه کاربر را شکل میدهد.
نرخ پردازش توکن پایداری سیستم و مدیریت خطاهای سرویس دهنده
پایداری سیستم به این معنی است که مدل بتواند حجم زیادی از درخواستها را بدون مشکل پردازش کند. این موضوع بهخصوص در زمان اوج استفاده اهمیت پیدا میکند.
نرخ پردازش توکن (Token Processing Rate) نشان میدهد که سیستم در یک بازه زمانی مشخص، چقدر توکن ورودی را پردازش و خروجی تولید میکند. این معیار به شما کمک میکند تا ظرفیت سیستم خود را بشناسید و از گلوگاهها جلوگیری کنید.
مدیریت خطاها هم بخش مهمی از پایداری است. وقتی خطایی رخ میدهد، باید بتوانید آن را سریع تشخیص دهید و علت آن را پیدا کنید. خطاهای رایج در این حوزه، عبارتند از:
- خطاهای مربوط به منابع (Resource Errors): مثل تمام شدن حافظه یا CPU.
- خطاهای مربوط به شبکه (Network Errors): مثل قطع شدن ارتباط با سرویسدهنده.
- خطاهای منطقی مدل (Model Logic Errors): مثل پاسخهای نامربوط یا تکراری.
مدیریت هزینه و ردگیری مصرف توکن در فراخوانی های چندمرحله ای
هزینه استفاده از مدلهای زبانی، بهخصوص مدلهای بزرگ، میتواند قابل توجه باشد. شما باید بتوانید هزینهها را دقیقاً ردگیری کنید تا بودجهبندی مناسبی داشته باشید.
مصرف توکن، معیار اصلی هزینه است. در فراخوانیهای چندمرحلهای (مثل مکالمات طولانی یا پردازشهای پیچیده)، ردگیری مجموع توکنهای ورودی و خروجی برای هر مرحله ضروری است. این کار به شما کمک میکند بفهمید کدام بخش از برنامه بیشترین هزینه را ایجاد میکند.
مثلاً، اگر یک ایجنت در حال برنامهریزی برای انجام یک کار است، هر مرحله از برنامهریزی و اجرای آن، توکن مصرف میکند. با رصد دقیق این مصرف، میتوانید فرایند را بهینه کرده و هزینهها را کاهش دهید. استفاده از ابزارهای رصدپذیری مدل زبانی در این زمینه بسیار کمککننده است.
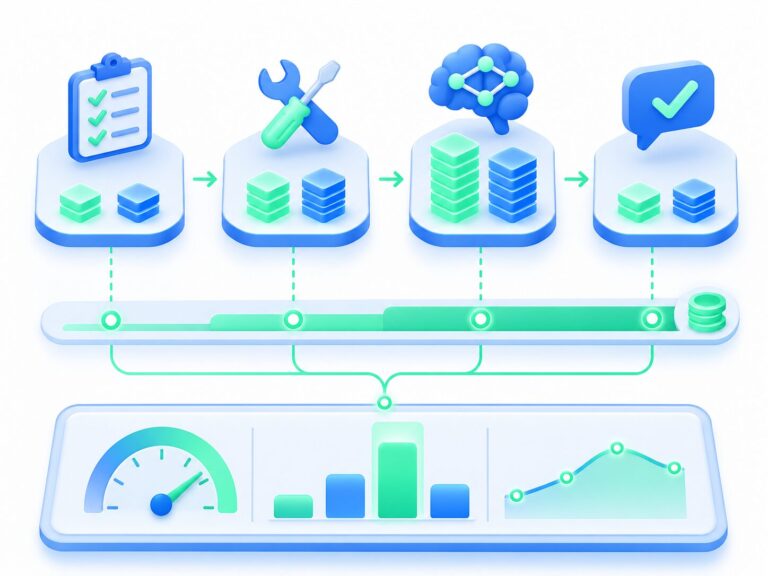
ردگیری هزینه فقط برای مدلهای تجاری نیست؛ حتی مدلهای متن باز هم نیاز به منابع محاسباتی دارند که هزینه دارد.
سنجش کیفیت خروجی توهم و روش ارزیابی مدل به عنوان داور
یکی از چالشهای بزرگ مدلهای زبانی، پدیده “توهم” (Hallucination) است. این یعنی مدل “اطلاعات نادرست یا بیمعنی” را به عنوان واقعیت ارائه میدهد.
سنجش کیفیت خروجی شامل ارزیابی دقیق برای جلوگیری از توهم است. این کار معمولاً با مقایسه خروجی مدل با دادههای واقعی یا با استفاده از مدلهای دیگر به عنوان داور انجام میشود. داور مدل، خروجی مدل اصلی را بررسی کرده و میزان دقت و صحت آن را ارزیابی میکند.
روشهای ارزیابی میتوانند شامل مقایسههای انسانی، معیارهای خودکار مثل ROUGE یا BLEU برای خلاصهسازی و ترجمه، یا استفاده از مدلهای زبانی دیگر برای سنجش کیفیت باشند. انتخاب روش مناسب به نوع کاربرد مدل بستگی دارد.
- ارزیابی انسانی: توسط انسانها برای سنجش کیفیت کلی.
- معیارهای خودکار: مثل دقت، بازیابی، F1-score برای تسکهای خاص.
- استفاده از مدل به عنوان داور: یک مدل دیگر، خروجی مدل اصلی را قضاوت میکند.
استفاده از ابزارهای رصدپذیری مدل زبانی به شما کمک میکند تا این توهمات را شناسایی و ردگیری کنید و در نهایت کیفیت خروجی را بهبود بخشید.
مزایای پیاده سازی رصدپذیری در چرخه حیات ایجنت های هوش مصنوعی
رصدپذیری (Observability) به شما کمک میکند تا بفهمید ایجنت هوش مصنوعی شما در هر لحظه چطور کار میکند. این یعنی دیدن جزئیات اتفاقاتی که داخل جعبه سیاه ایجنت میافتد. این کار خیلی مهم است چون ایجنتها پیچیده هستند و همیشه آنطور که انتظار داریم رفتار نمیکنند.
وقتی رصدپذیری را پیاده میکنید، میتوانید مشکلات را سریعتر پیدا و رفع کنید. مثل این است که یک پزشک بتواند با دستگاههای مختلف، وضعیت دقیق بدن بیمار را ببیند و بیماری را زودتر تشخیص دهد.
این کار به بهینهسازی عملکرد ایجنت هم کمک میکند. شما میتوانید بفهمید کدام بخشها کند هستند یا کدام قسمتها بیشتر منابع مصرف میکنند. این اطلاعات به شما کمک میکند تا ایجنت را سریعتر و با هزینه کمتر اجرا کنید.
رصدپذیری فقط برای پیدا کردن باگ نیست؛ بلکه ابزاری قدرتمند برای درک عمیق رفتار ایجنت و بهبود مستمر آن است.
با داشتن رصدپذیری، میتوانید اعتماد کاربران را هم جلب کنید. وقتی کاربران بدانند که ایجنت شما قابل اعتماد است و مشکلاتش سریع حل میشود، بیشتر به آن اعتماد میکنند. این موضوع برای کسبوکارهایی که از ایجنتها در خدمات مشتری یا پردازش داده استفاده میکنند، حیاتی است.
همچنین، رصدپذیری به شما کمک میکند تا مطمئن شوید ایجنت با قوانین و مقررات همخوانی دارد. شما میتوانید ردپای تمام تصمیمات و پردازشهای ایجنت را ببینید و در صورت نیاز، آن را به مراجع قانونی یا حسابرسان نشان دهید.
با تفاوت رویکردهای RAG و عاملهای هوش مصنوعی در پروژههای مختلف آشنا شوید. Agentic RAG؛ بهترین انتخاب برای پروژههای AI
- عیبیابی سریعتر و دقیقتر مشکلات.
- بهینهسازی مصرف منابع و کاهش هزینهها.
- بهبود کیفیت و دقت پاسخهای ایجنت.
- افزایش اعتماد کاربران و مشتریان.
- تضمین انطباق با قوانین و مقررات.
در نهایت، رصدپذیری به شما این امکان را میدهد که ایجنتهای هوش مصنوعی خود را با اطمینان بیشتری توسعه دهید و مدیریت کنید. این یعنی میتوانید نوآوری کنید و از قدرت هوش مصنوعی برای کسبوکارتان بهره ببرید.
استاندارد اوپن تلمتری و نقش آن در ردگیری جریان داده های هوش مصنوعی
برای اینکه بتوانیم جریان دادهها در مدلهای زبانی و ایجنتهای هوش مصنوعی را به خوبی رصد کنیم، به یک استاندارد مشترک نیاز داریم. اوپن تلمتری (OpenTelemetry) این استاندارد را فراهم میکند. این استاندارد به ما کمک میکند تا اطلاعات لازم از نحوه عملکرد سیستم را جمعآوری کنیم.
با استفاده از اوپن تلمتری، میتوانیم ردپای دقیقی از درخواستها و پاسخهای مدلهای زبانی داشته باشیم. این استاندارد به ما اجازه میدهد تا بفهمیم دادهها در کجای سیستم پردازش شدهاند و چه اتفاقی برایشان افتاده است.
این اطلاعات برای عیبیابی و بهینهسازی عملکرد مدلهای هوش مصنوعی بسیار حیاتی است. بدون یک استاندارد واحد، جمعآوری و مقایسه دادهها از سیستمهای مختلف بسیار دشوار خواهد بود.
اوپن تلمتری مانند یک زبان مشترک برای ابزارهای مختلف رصدپذیری عمل میکند و امکان یکپارچهسازی و تبادل داده را فراهم میآورد.
استاندارد اوپن تلمتری به طور خاص برای جمعآوری تلمتری (telemetry) طراحی شده است. تلمتری شامل دادههایی مثل تِرِیس (trace)، متریک (metric) و لاگ (log) میشود. این سه جزء به ما کمک میکنند تا تصویری کامل از وضعیت سیستم داشته باشیم.
هر یک از سه جزء تلمتری نقش خاص خود را دارد:
- ترِیسها نشان میدهند که یک درخواست چگونه در سیستم حرکت کرده و چه مراحلی را طی کرده است
- متریکها معیارهای کمی از عملکرد سیستم را ارائه میدهند، مثل تعداد درخواستها در ثانیه
- لاگها جزئیات رویدادها را ثبت میکنند
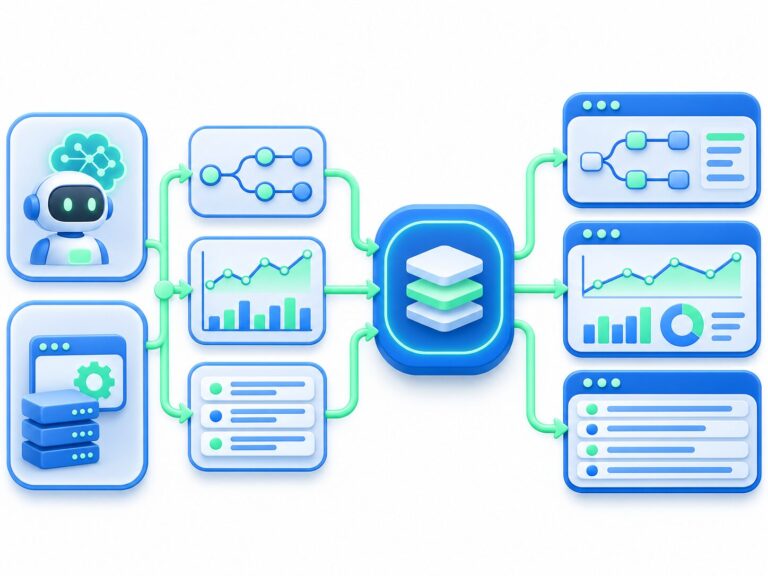
برای ابزارهای متنباز مانند اوپنالالمتری (OpenLLMetry) و لانگچِین (LangChain)، پیروی از استاندارد اوپن تلمتری اهمیت زیادی دارد. این پیروی باعث میشود بتوانیم دادههای تولید شده توسط این ابزارها را به راحتی با دیگر سیستمهای رصدپذیری مثل دیتاداگ (Datadog) یا اسپِلَنک (Splunk) یکپارچه کنیم.
این یکپارچگی به ما امکان میدهد تا از تمام قابلیتهای ابزارهای رصدپذیری، از جمله تحلیلهای پیشرفته و داشبوردهای سفارشی، استفاده کنیم. این امر در نهایت به بهبود عملکرد و پایداری ایجنتهای هوش مصنوعی کمک میکند.
معیارهای انتخاب ابزار رصدپذیری متناسب با زیرساخت سازمان
برای انتخاب بهترین ابزار رصدپذیری، باید نیازهای خاص زیرساخت و تیم خودتان را در نظر بگیرید. هیچ ابزاری برای همه سازمانها مناسب نیست.
به عنوان مثال، اگر تیم شما کوچک است و تازه شروع کردهاید، شاید یک ابزار متنباز ساده کافی باشد. اما اگر سازمان بزرگی دارید و با حجم زیادی از دادهها سروکار دارید، به ابزارهای قدرتمندتر و مقیاسپذیرتری نیاز خواهید داشت.
همچنین، به مهارتهای فنی تیم خودتان توجه کنید. آیا تیم شما با ابزارهای پیچیده راحت است یا ترجیح میدهید راهحلی ساده و سرراست داشته باشید؟
مهمترین نکته این است که ابزار انتخابی باید به خوبی با معماری فعلی شما ادغام شود و فرآیندهای موجودتان را مختل نکند.
باید ببینید ابزار مورد نظر از چه نوع دادههایی پشتیبانی میکند و چقدر انعطافپذیری برای سفارشیسازی دارد. آیا میتوانید معیارهای خاص خودتان را تعریف کنید یا فقط از الگوهای آماده استفاده کنید؟
اگر در انتخاب ابزار عامل هوش مصنوعی متناسب با تیم و معماری پروژه تردید دارید، این مقاله را بخوانید:
آشنایی با 7 مدل عامل هوش مصنوعی برای خودکار کردن فرایندهای کاری در سال 2025
هزینه هم فاکتور مهمی است. ابزارهای متنباز معمولاً هزینه لایسنس ندارند، اما ممکن است هزینههای نگهداری و توسعه بالاتری داشته باشند. ابزارهای تجاری معمولاً گرانترند اما پشتیبانی و قابلیتهای بیشتری ارائه میدهند.
در نهایت، به دنبال ابزاری باشید که بتواند با رشد سازمان شما مقیاسپذیر باشد و در آینده نیز نیازهایتان را برآورده کند.
- مقیاسپذیری ابزار برای رشد آینده.
- هزینه کلی (لایسنس، پیادهسازی، نگهداری).
- سهولت استفاده و یادگیری برای تیم.
- قابلیت ادغام با زیرساخت فعلی.
- پشتیبانی از انواع دادهها و معیارهای سفارشی.
برترین ابزارهای متن باز رصدپذیری مدل زبانی و ایجنت هوش مصنوعی
انتخاب ابزار مناسب برای رصدپذیری ایجنتهای هوش مصنوعی، به شما کمک میکند تا از عملکرد صحیح آنها مطمئن شوید. این ابزارها مانند جعبه سیاه پرواز عمل میکنند و جزئیات اتفاقات را برایتان ثبت میکنند.
در این بخش، چند ابزار متن باز محبوب و کارآمد را بررسی میکنیم که در جامعه توسعهدهندگان هوش مصنوعی جایگاه ویژهای دارند.
این ابزارهای متن باز، قابلیتهای متنوعی برای مدیریت، عیبیابی و بهینهسازی ایجنتها ارائه میدهند. بسیاری از آنها روی ذخیرهسازی دادهها در دیتابیسهای رایج مثل PostgreSQL یا ClickHouse تمرکز کردهاند. این امکان به شما اجازه میدهد تا دادههای ارزشمند مربوط به اجرای ایجنتها را به صورت ساختاریافته ذخیره و تحلیل کنید.
یادداشت سردبیر: مفاهیم پایهای ایجنت هوش مصنوعی و Agentic RAG در مقالات پیشین وبلاگ لیارا به طور کامل پوشش داده شدهاند. لطفا از تکرار این تعاریف خودداری کرده و به مقالات مربوطه لینک داخلی دهید. تمرکز اصلی در این بخش بر قابلیت سلفهاست (self-hosted) و ذخیرهسازی اطلاعات در دیتابیسهای داخلی مانند PostgreSQL یا ClickHouse است.
بررسی ابزار لنگ فیوز برای ردگیری مدیریت پرامپت و ارزیابی
لنگ فیوز (Langfuse) یک پلتفرم متن باز برای رصدپذیری ایجنتهای هوش مصنوعی است. این ابزار به شما کمک میکند تا جریان اجرای پرامپتها، پاسخهای مدل و سایر دادههای مربوط به تعاملات ایجنت را پیگیری کنید.
با استفاده از لنگ فیوز، میتوانید به راحتی عملکرد پرامپتهای مختلف را مقایسه و بهترین نسخه آنها را شناسایی کنید.
یکی از قابلیتهای کلیدی لنگ فیوز، امکان ارزیابی خودکار خروجی مدلها است. شما میتوانید معیارهای ارزیابی را تعریف کنید و لنگ فیوز به صورت خودکار خروجیهای ایجنت را بر اساس این معیارها بسنجد. این موضوع برای اطمینان از کیفیت و دقت پاسخهای ایجنت بسیار مهم است.
لنگ فیوز از دیتابیسهایی مانند PostgreSQL برای ذخیرهسازی دادههای رصد استفاده میکند. این انعطافپذیری به شما امکان میدهد زیرساخت ذخیرهسازی موجود خود را به کار بگیرید و نیازی به راهاندازی سیستم جدید نداشته باشید. همچنین این ابزار را میتوان به راحتی با Docker راهاندازی کرد. قابلیتهای اصلی لنگ فیوز عبارتند از:
- ردگیری دقیق تاریخچه پرامپتها و پاسخها.
- ارزیابی خودکار کیفیت خروجی مدل.
- مقایسه عملکرد پرامپتهای مختلف.
- ذخیرهسازی دادهها در PostgreSQL.
بررسی ابزار فونیکس برای عیب یابی محلی ایجنت ها و داده های برداری
فونیکس (Phoenix) ابزاری متن باز است که به طور خاص برای عیبیابی ایجنتهای هوش مصنوعی و دادههای برداری (Vector Data) طراحی شده است. اگر ایجنت شما با دادههای برداری کار میکند، فونیکس میتواند به شما در درک نحوه پردازش این دادهها و شناسایی مشکلات احتمالی کمک کند.
پیشنهاد مطالعه: با نقش ابزارهای رصدپذیری و فونیکس در عیبیابی ایجنتهای هوش مصنوعی آشنا شوید.
عامل هوش مصنوعی چیست؟ هر آنچه باید در مورد آنها بدانید
این ابزار به شما اجازه میدهد تا به صورت محلی (local) اجرای ایجنت خود را رصد کنید. این قابلیت برای توسعهدهندگانی که در محیط توسعه خود به دنبال شناسایی سریع باگها و مشکلات هستند، بسیار مفید است. فونیکس جزئیات دقیقی از نحوه تعامل ایجنت با دادههای برداری ارائه میدهد.
فونیکس همچنین از ذخیرهسازی دادهها در دیتابیسهای متنباز پشتیبانی میکند. این امکان به شما کمک میکند تا دادههای مربوط به جستجوهای برداری و نتایج آنها را ثبت و تحلیل کنید. این قابلیت برای بهینهسازی سیستمهای جستجوی معنایی و توصیهگر حیاتی است. قابلیتهای اصلی فونیکس عبارتند از:
- عیبیابی تخصصی دادههای برداری.
- رصد اجرای محلی ایجنت.
- تجسم جستجوهای برداری.
- پشتیبانی از ذخیرهسازی در دیتابیسهای متنباز.
بررسی ابزار لامینار برای رصد دقیق جریان کارهای طولانی ایجنت ها
لامینار (Laminar) ابزاری قدرتمند برای رصد ورکفلوهای پیچیده و طولانی ایجنتهای هوش مصنوعی است. بسیاری از ایجنتهای پیشرفته شامل چندین مرحله پردازش و تعامل با سرویسهای مختلف هستند. لامینار به شما کمک میکند تا تمام این مراحل را به صورت بصری و دقیق مشاهده کنید.
با استفاده از لامینار، میتوانید نقاط شکست (bottlenecks) در ورکفلو خود را شناسایی کنید. این ابزار جزئیات هر مرحله، زمان صرف شده و نتایج آن را ثبت میکند. این اطلاعات برای بهینهسازی عملکرد و کاهش زمان پاسخدهی ایجنت بسیار ارزشمند است.
لامینار از ذخیرهسازی دادهها در دیتابیسهای رابطهای مانند PostgreSQL پشتیبانی میکند. این به شما امکان میدهد تا تاریخچه اجرای ورکفلوها را برای تحلیلهای بعدی ذخیره کنید. راهاندازی لامینار با Docker نیز فرآیندی ساده است و به سرعت میتوانید آن را روی پلتفرمهای ابری مانند لیارا مستقر کنید. ویژگیهای مهم لامینار عبارتند از:
- تجسم ورکفلوهای چندمرحلهای.
- شناسایی نقاط ضعف و گلوگاهها.
- ثبت جزئیات هر مرحله از پردازش.
- پشتیبانی از PostgreSQL برای ذخیرهسازی داده.
بررسی ابزار تریس لوپ و پکیج اوپن ال ال متری برای تلمتری استاندارد
تریس لوپ (TraceLoop) یک کتابخانه پایتون است که به شما کمک میکند تا تلمتری (Telemetry) استاندارد را برای ایجنتهای هوش مصنوعی خود پیادهسازی کنید. تلمتری به جمعآوری و ارسال دادههای عملکردی و رفتاری سیستم اشاره دارد.
این ابزار از استاندارد OpenTelemetry پشتیبانی میکند. OpenTelemetry یک استاندارد صنعتی برای جمعآوری تلمتری است که امکان ارسال دادهها به سیستمهای مختلف مانیتورینگ را فراهم میکند. این انعطافپذیری به شما اجازه میدهد تا دادههای ایجنت خود را به ابزارهای دلخواهتان ارسال کنید.
با استفاده از تریس لوپ، میتوانید ردپای (Trace) اجرای درخواستها را ثبت کنید. این ردپاها شامل تمام مراحل پردازش، فراخوانیهای API و زمان صرف شده در هر مرحله هستند. این اطلاعات برای درک کامل چرخه حیات یک درخواست و عیبیابی مشکلات ضروری است. ویژگیهای مهم تریس لوپ عبارتند از:
- پیادهسازی تلمتری با استاندارد OpenTelemetry.
- ثبت ردپای کامل اجرای درخواستها.
- ارسال دادهها به سیستمهای مانیتورینگ مختلف.
- مدیریت آسانتر دادههای عملکردی.
در پلتفرم ابری لیارا، شما میتوانید به راحتی این ابزارها را با استفاده از Docker مستقر کنید. اتصال به سرویسهای هوش مصنوعی لیارا و استفاده از زیرساختهای مقیاسپذیر ما، فرآیند راهاندازی و مدیریت ایجنتهای هوش مصنوعی را برای شما سادهتر میکند.
اگر میخواهید تفاوت ایجنت و چتبات و روش سادهتر استقرار آنها را بدانید، بخوانید:
عامل هوش مصنوعی (AI Agents) یا چت بات چیست؟ تفاوت ها و کاربرد ها
برترین پلتفرم های ابری و تجاری رصدپذیری مدل زبانی
در کنار ابزارهای متنباز، پلتفرمهای ابری و تجاری هم گزینههای خوبی برای رصدپذیری مدلهای زبانی هستند. این ابزارها معمولاً امکانات بیشتری دارند و پشتیبانی بهتری ارائه میدهند. برای انتخاب بین ابزارهای متنباز و تجاری، باید نیازهای پروژه، بودجه و تخصص تیم خود را در نظر بگیرید.
اگر به دنبال راهحلی سریع و با پشتیبانی حرفهای هستید، پلتفرمهای تجاری گزینه مناسبیاند. این ابزارها معمولاً رابط کاربری سادهتری دارند و پیادهسازی آنها سریعتر است. همچنین، امکانات پیشرفتهای مثل تحلیلهای عمیقتر، هشدارهای هوشمند و ادغام با سایر ابزارهای سازمانی را ارائه میدهند.
این پلتفرمها به شما کمک میکنند تا از سلامت و کارایی مدلهای زبانی خود در محیط عملیاتی مطمئن شوید. با رصد دقیق، میتوانید مشکلات احتمالی را سریعتر شناسایی و رفع کنید و از عملکرد بهینه مدلها مطمئن شوید.
این امر بهخصوص در پروژههای بزرگ و حساس که نیاز به پایداری بالا دارند، بسیار حیاتی است.
بررسی ابزار لنگ اسمیت برای رصد و ارزیابی پروژه های لنگ چین و لنگ گراف
لنگ اسمیت (LangSmith) یکی از ابزارهای محبوب برای رصد و اشکالزدایی پروژههای مبتنی بر مدلهای زبانی بزرگ (LLMs) است. این پلتفرم به شما کمک میکند تا ورکفلو ایجنتها و برنامههای خود را به طور کامل مشاهده و تحلیل کنید.
با استفاده از لنگ اسمیت، میتوانید تمام مراحل اجرای یک پرامپت یا یک تسک پیچیده را رصد کنید. این شامل مشاهده ورودیها، خروجیها، پارامترهای مدل، و حتی توکنهای مصرفی است. این اطلاعات برای درک رفتار مدل و شناسایی نقاط ضعف بسیار مفید هستند.
لنگ اسمیت بهخصوص برای پروژههایی که از فریمورکهایی مثل لنگچین (LangChain) یا لنگگراف (LangGraph) استفاده میکنند، کاربرد زیادی دارد. این ابزار به شما امکان میدهد تا نمودار اجرای برنامه (execution graph) را ببینید و ببینید که کدام بخشها کند هستند یا خطا میدهند.
یکی از قابلیتهای کلیدی لنگ اسمیت، ارزیابی خودکار خروجی مدلها است. شما میتوانید معیارهای ارزیابی تعریف کنید و لنگ اسمیت به طور مداوم خروجی مدل را با این معیارها مقایسه کند. این کار به شما کمک میکند تا کیفیت پاسخهای مدل را در طول زمان حفظ کنید.
لنگ اسمیت به شما دید کاملی از نحوه تعامل ایجنت شما با ابزارها و دیتابیسها میدهد و به اشکالزدایی سریعتر کمک میکند.
بررسی ابزار برین تراست برای ارزیابی مستمر و اعتبارسنجی در فرآیند استقرار
برینتراست (Braintrust) یک پلتفرم برای ارزیابی و بهبود مدلهای هوش مصنوعی، بهویژه مدلهای زبانی بزرگ است. این ابزار تمرکز زیادی بر ارزیابی مداوم و اعتبارسنجی در چرخه عمر مدل دارد.
هدف اصلی برینتراست، کمک به توسعهدهندگان برای درک بهتر عملکرد مدلهایشان در شرایط واقعی است. این پلتفرم به شما امکان میدهد تا دادههای ورودی، خروجی مدل، و معیارهای ارزیابی را ثبت و تحلیل کنید.
برینتراست از مفاهیم کلیدی مثل “ویو” (View) و “پایپلاین” (Pipeline) استفاده میکند تا بتوانید جریان دادهها و مراحل پردازش را به صورت سازمانیافته مشاهده کنید. این ابزار به شما کمک میکند تا ببینید مدل شما در چه مواردی خوب عمل میکند و در چه مواردی نیاز به بهبود دارد.
یکی از مزایای برینتراست، قابلیت مقایسه نتایج مدلهای مختلف یا نسخههای متفاوت یک مدل است. شما میتوانید به راحتی عملکرد مدلها را بر اساس معیارهای تعریفشده مقایسه کنید و بهترین گزینه را انتخاب کنید. این ویژگی برای فاینتیون و بهینهسازی مدل بسیار کاربردی است.
ببینید سیستمهای چندعاملی چگونه با مقایسه و هماهنگی مدلها بهرهوری را افزایش میدهند. سیستمهای چندعاملی در هوش مصنوعی چیست؟ چطور باعث افزایش بهرهوری میشوند؟
این پلتفرم از انواع مدلهای هوش مصنوعی پشتیبانی میکند و در دیپلوی مدلها نقش مهمی دارد. با اعتبارسنجی مداوم، میتوانید از پایداری و دقت مدل خود در محیط عملیاتی مطمئن شوید.
برترین پلتفرم های جامع سازمانی با قابلیت مانیتورینگ هوش مصنوعی
وقتی صحبت از مدیریت و نظارت بر سیستمهای پیچیده سازمانی میشود، پلتفرمهای جامع نقش کلیدی دارند. این پلتفرمها معمولاً مجموعهای از ابزارها را برای مانیتورینگ، لاگگیری، ردیابی عملکرد و مدیریت زیرساخت ارائه میدهند.
در سالهای اخیر، با رشد سریع هوش مصنوعی و مدلهای زبانی بزرگ (LLM)، این پلتفرمها قابلیتهای جدیدی برای رصدپذیری (Observability) هوش مصنوعی نیز به مجموعه خود اضافه کردهاند.
این قابلیتها به سازمانها کمک میکند تا عملکرد مدلهای هوش مصنوعی خود را در کنار سایر بخشهای سیستم، به صورت یکپارچه مشاهده کنند. این موضوع برای درک بهتر رفتار مدلها، شناسایی مشکلات و بهینهسازی آنها حیاتی است.
ترکیب مانیتورینگ سنتی با قابلیتهای رصدپذیری هوش مصنوعی، دید جامعی از کل سیستم در اختیار مدیران قرار میدهد.
این پلتفرمها با جمعآوری دادهها از منابع مختلف، از جمله لاگهای برنامه، معیارهای عملکرد سیستم، و دادههای ورودی و خروجی مدلهای هوش مصنوعی، تصویری کامل از وضعیت سیستم ارائه میدهند. این اطلاعات برای عیبیابی سریع، پیشبینی مشکلات و اطمینان از عملکرد بهینه سیستم ضروری است.
قابلیت های نظارت هوش مصنوعی در دیتاداگ دایناتریس و اسپلانک
پلتفرمهایی مثل دیتاداگ (Datadog)، دایناتریس (Dynatrace) و اسپلانک (Splunk) در حال حاضر از پیشتازان ارائه قابلیتهای جامع نظارت بر هوش مصنوعی در محیطهای سازمانی هستند. این ابزارها به شما امکان میدهند تا مدلهای زبانی خود را با دقت بالا رصد کنید.
قابلیتهای کلیدی این پلتفرمها شامل ردیابی درخواستهای ورودی و خروجی مدلها و محاسبه معیارهایی مثل تاخیر (Latency) و نرخ پردازش توکن است. آنها همچنین توهم (Hallucination) را در پاسخهای مدل شناسایی و تحلیل میکنند. این ابزارها به طور خودکار دادههای لازم را جمعآوری و نمایش میدهند.
همچنین، این پلتفرمها امکان مقایسه عملکرد مدلهای مختلف، ردگیری هزینههای مربوط به فراخوانی APIهای مدلهای زبانی، و بررسی کیفیت خروجیها را فراهم میکنند. با استفاده از این ابزارها، سازمانها میتوانند اطمینان حاصل کنند که مدلهای هوش مصنوعی آنها به طور موثر و کارآمد عمل میکنند.
برای درک بهتر مفاهیم پایه ایجنتها، پیشنهاد میکنیم مقالات عامل هوش مصنوعی و Agentic RAG را مطالعه کنید.
این ابزارها به شما کمک میکنند تا جریان کاری کامل یک ایجنت هوش مصنوعی را از ابتدا تا انتها مشاهده کنید. این شامل مراحل پردازش ورودی، فراخوانی مدلهای زبانی، و تولید خروجی نهایی است. این دید جامع برای اشکالزدایی و بهبود عملکرد ایجنتها بسیار مفید است.
دیتاداگ، دایناتریس و اسپلانک با ادغام قابلیتهای مانیتورینگ سنتی و هوش مصنوعی، راهکاری یکپارچه برای نظارت بر کل زیرساخت و برنامههای کاربردی شما ارائه میدهند. این موضوع به تیمهای فنی کمک میکند تا با سرعت بیشتری مشکلات را شناسایی و رفع کنند.
جدول مقایسه جامع ابزارهای رصدپذیری مدل زبانی و ایجنت های هوش مصنوعی
انتخاب ابزار مناسب برای رصدپذیری مدلهای زبانی و ایجنتهای هوش مصنوعی، به نیازهای خاص پروژه شما بستگی دارد. این جدول به شما کمک میکند تا مقایسهای سریع بین ابزارهای مختلف داشته باشید.
اگر میخواهید مسیر پردازش درخواست تا تولید خروجی را بهتر درک کنید، این مقاله را بخوانید:
قبل از هر خروجی هوش مصنوعی، چه اتفاقی می افتد؟
| ابزار | لایسنس | میزبانی | سازگاری با OpenTelemetry | مناسب برای |
|---|---|---|---|---|
| Langfuse | Apache 2.0 | Self-hosted / Cloud | بالا | مدیریت پرامپت، ارزیابی، ردیابی |
| Arize AI | تجاری | Cloud | متوسط | مانیتورینگ مدل، توضیحپذیری |
| OpenLLMetry | Apache 2.0 | Self-hosted | بالا | تلمتری استاندارد، ردیابی |
| LangSmith | تجاری | Cloud | بالا | پروژههای LangChain، ارزیابی |
| Datadog / Dynatrace / Splunk | تجاری | Cloud | متوسط | مانیتورینگ جامع سازمانی |
ابزارهای متنباز مثل Langfuse و OpenLLMetry انعطافپذیری زیادی برای میزبانی شخصی و سفارشیسازی دارند. این ابزارها برای تیمهایی که به دنبال کنترل کامل بر دادهها و زیرساخت خود هستند، ایدهآل است.
آنها اغلب از استاندارد OpenTelemetry پشتیبانی میکنند و به شما امکان میدهند تا دادههای رصدپذیری را در کنار سایر سیستمهای خود جمعآوری کنید.
پلتفرمهای ابری و تجاری مانند LangSmith و Arize AI، راهاندازی سریع و قابلیتهای پیشرفتهتری را ارائه میدهند. این ابزارها برای تیمهایی که به دنبال راهحلهای آماده و مقیاسپذیر هستند، مناسبترند.
آنها معمولاً رابط کاربری بهتری برای تحلیل و مصورسازی دادهها دارند و به شما کمک میکنند تا به سرعت مشکلات را شناسایی و برطرف کنید.
هنگام انتخاب ابزار، به میزان پشتیبانی از OpenTelemetry، گزینههای میزبانی (Self-hosted یا Cloud)، و قابلیتهای خاص مورد نیازتان (مثل مدیریت پرامپت یا ارزیابی مدل) توجه کنید. لیارا با ارائه زیرساخت ابری قدرتمند و اتصال آسان به سرویسهای هوش مصنوعی، پیادهسازی این ابزارها را برای شما تسهیل میکند.
پیاده سازی رصدپذیری و زیرساخت ایجنت های هوش مصنوعی در سرورهای ابری لیارا
برای پیادهسازی رصدپذیری ایجنتهای هوش مصنوعی، زیرساخت مناسب نقش کلیدی دارد. لیارا این امکان را به شما میدهد که به سرعت محیط مورد نیازتان را با استفاده از داکر (Docker) راهاندازی کنید. این یعنی نیازی نیست نگران تنظیمات پیچیده زیرساخت باشید و میتوانید روی منطق ایجنت خود تمرکز کنید.
پس از راهاندازی ایجنت، باید بتوانید خروجی و رفتارهای آن را رصد کنید. لیارا این کار را با اتصال به سرویسهای هوش مصنوعی مختلف آسان کرده است. شما میتوانید لاگها (logs) و معیارهای عملکرد ایجنت خود را به راحتی مشاهده و تحلیل کنید.
برای ذخیرهسازی دادههای مهم یا نتایج پردازشها، میتوانید از سرویس دیتابیسهای متنوع لیارا مانند PostgreSQL یا ClickHouse استفاده کنید. این دیتابیسها برای ذخیره و تحلیل دادههای حجیم و سری زمانی بسیار مناسب هستند و به شما کمک میکنند تا الگوهای رفتاری ایجنت خود را بهتر درک کنید.
استفاده از پلتفرم ابری PaaS لیارا، فرآیند دیپلوی (deploy) و مدیریت ایجنتهای هوش مصنوعی را سادهتر و سریعتر میکند.
ابزارهای متنباز مانند Langfuse برای مدیریت پرامپتها و ارزیابی خروجیها، یا Phoenix برای عیبیابی دادههای برداری، میتوانند به صورت کانتینری (container) روی لیارا اجرا شوند. این انعطافپذیری به شما اجازه میدهد تا بهترین ابزارها را متناسب با نیاز پروژه خود انتخاب کنید.
جمع بندی
پیادهسازی رصدپذیری در ایجنتهای هوش مصنوعی، دیگر یک انتخاب نیست، بلکه یک ضرورت است. این ابزارها به شما کمک میکنند تا عملکرد مدلهای زبانی را درک کنید، مشکلات را سریعتر پیدا کنید و کیفیت خروجی را بهبود ببخشید. بدون رصدپذیری، مدیریت و بهینهسازی سیستمهای پیچیده هوش مصنوعی تقریباً غیرممکن است.
انتخاب ابزار مناسب به نیازهای خاص پروژه شما بستگی دارد. ابزارهای متن باز مثل لنگ فیوز (Langfuse) و فونیکس (Phoenix) انعطافپذیری بالایی ارائه میدهند و برای تیمهایی که به دنبال کنترل کامل هستند، عالیاند. این ابزارها امکان ردگیری مدیریت پرامپت، عیبیابی دادههای برداری و رصد جریان کار را فراهم میکنند.
برای آشنایی بیشتر با مفاهیم پایهای ایجنت، میتوانید مقالات عامل هوش مصنوعی و Agentic RAG در وبلاگ لیارا را مطالعه کنید.
پلتفرمهای ابری و تجاری مانند لنگ اسمیت (LangSmith) و برین تراست (BrainTrust) راهحلهای جامعتری برای ارزیابی مستمر و اعتبارسنجی در فرآیند استقرار ارائه میدهند. این ابزارها به ویژه برای پروژههای بزرگ و تیمهایی که به دنبال یکپارچگی و پشتیبانی قوی هستند، مناسباند.
در نهایت، لیارا با ارائه زیرساخت ابری قدرتمند و اتصال آسان به سرویسهای هوش مصنوعی، راهاندازی و مدیریت ایجنتهای هوش مصنوعی را برای شما ساده میکند. شما میتوانید با استفاده از داکر (Docker)، به سرعت ایجنتهای خود را روی پلتفرم ابری لیارا مستقر کرده و از قابلیتهای رصدپذیری بهرهمند شوید.
- ردگیری دقیق جریان دادههای هوش مصنوعی با استفاده از استانداردهایی مثل اوپن تلمتری (OpenTelemetry).
- مدیریت بهینه هزینهها با رصد مصرف توکن در فراخوانیهای چندمرحلهای.
- کاهش توهم (Hallucination) و افزایش کیفیت خروجی مدلها از طریق ارزیابی مستمر.
سوالات متداول
تفاوت مانیتورینگ سنتی با رصدپذیری مدل زبانی چیست؟
مانیتورینگ سنتی روی معیارهای بیرونی مثل آپتایم و مصرف منابع تمرکز دارد. رصدپذیری مدل زبانی به شما اجازه میدهد لایههای عمیقتر عملکرد درونی مدلهای هوش مصنوعی را درک و تحلیل کنید و دلیل نتایج را بفهمید.
متریک TTFT در پردازش مدل زبانی چیست و چرا اهمیت بالایی دارد؟
TTFT یا “زمان تا اولین توکن” نشان میدهد چقدر طول میکشد تا مدل اولین بخش از پاسخ را تولید کند. این متریک برای روان بودن مکالمه در چتباتها و حس بهتر کاربر اهمیت زیادی دارد.
آیا استفاده از ابزارهای رصدپذیری تاخیر پاسخگویی ایجنت را افزایش می دهد؟
استفاده از ابزارهای رصدپذیری معمولاً تاخیر قابل توجهی به پاسخگویی ایجنت اضافه نمیکند. این ابزارها برای درک بهتر عملکرد طراحی شدهاند و با پیادهسازی صحیح، به بهینهسازی سرعت هم کمک میکنند.
چرا ابزار Langfuse محبوب ترین انتخاب متن باز برای تیم های توسعه است؟
لنگفیوز (Langfuse) به دلیل قابلیت ارزیابی خودکار خروجی مدلها و استفاده از پایگاهدادههای رایج مانند PostgreSQL، به یک انتخاب محبوب تبدیل شده است. این ابزار مدیریت و عیبیابی ایجنتهای هوش مصنوعی را آسان میکند.
چگونه می توان در برنامه های هوش مصنوعی هزینه مصرف توکن را به ازای هر کاربر رهگیری کرد؟
برای رهگیری هزینه توکن به ازای هر کاربر، باید هر درخواست یا عملیات ایجنت را به کاربری که آن را انجام داده، مرتبط کنید. سپس مصرف توکن هر مرحله را جمع بزنید و به حساب همان کاربر منظور کنید.